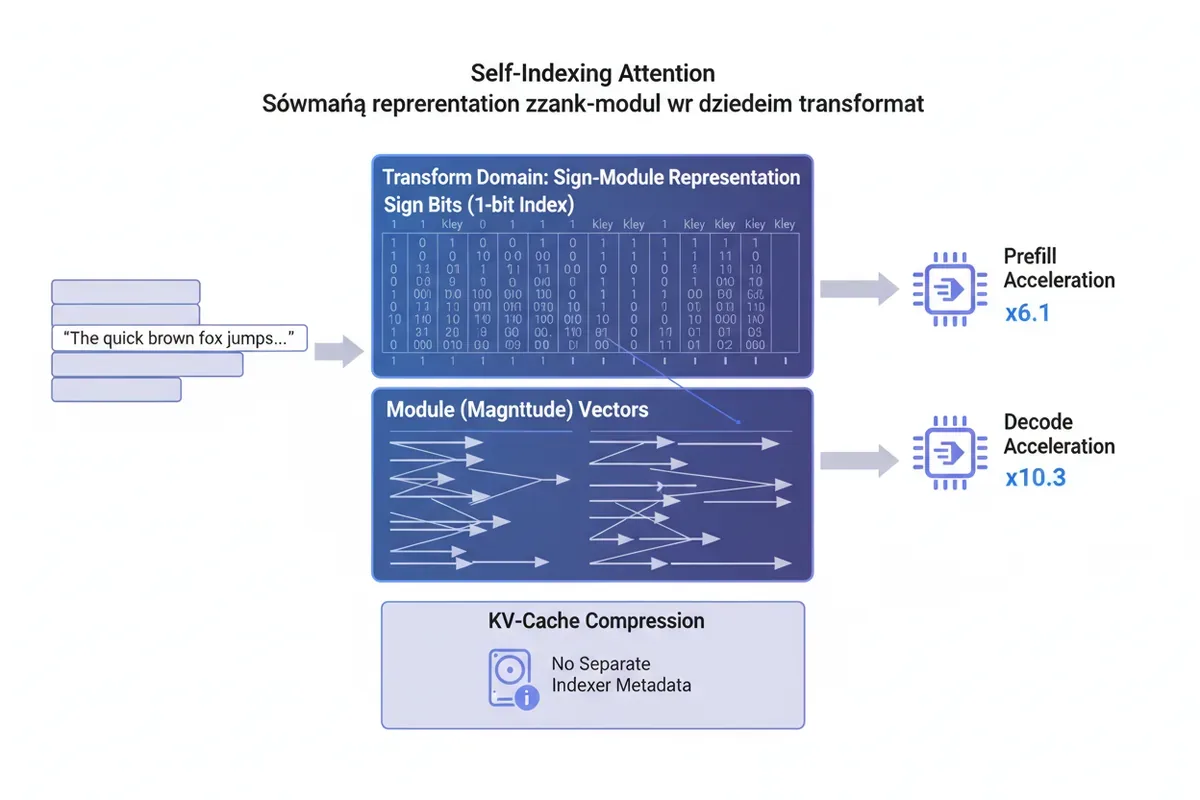
[DO PRZEGLĄDU] Jak zamienić klucze atencji w 1-bitowy indeks i przyspieszyć model językowy 10 razy
Długie konteksty w modelach językowych pożerają pamięć i czas – każdy dodatkowy token mnoży obliczenia. Zespół Xu Yanga znalazł sposób, żeby z samych kluczy atencji zrobić odchudzony indeks, który mówi modelowi, które tokeny są ważne,…