Posłuchaj artykułu
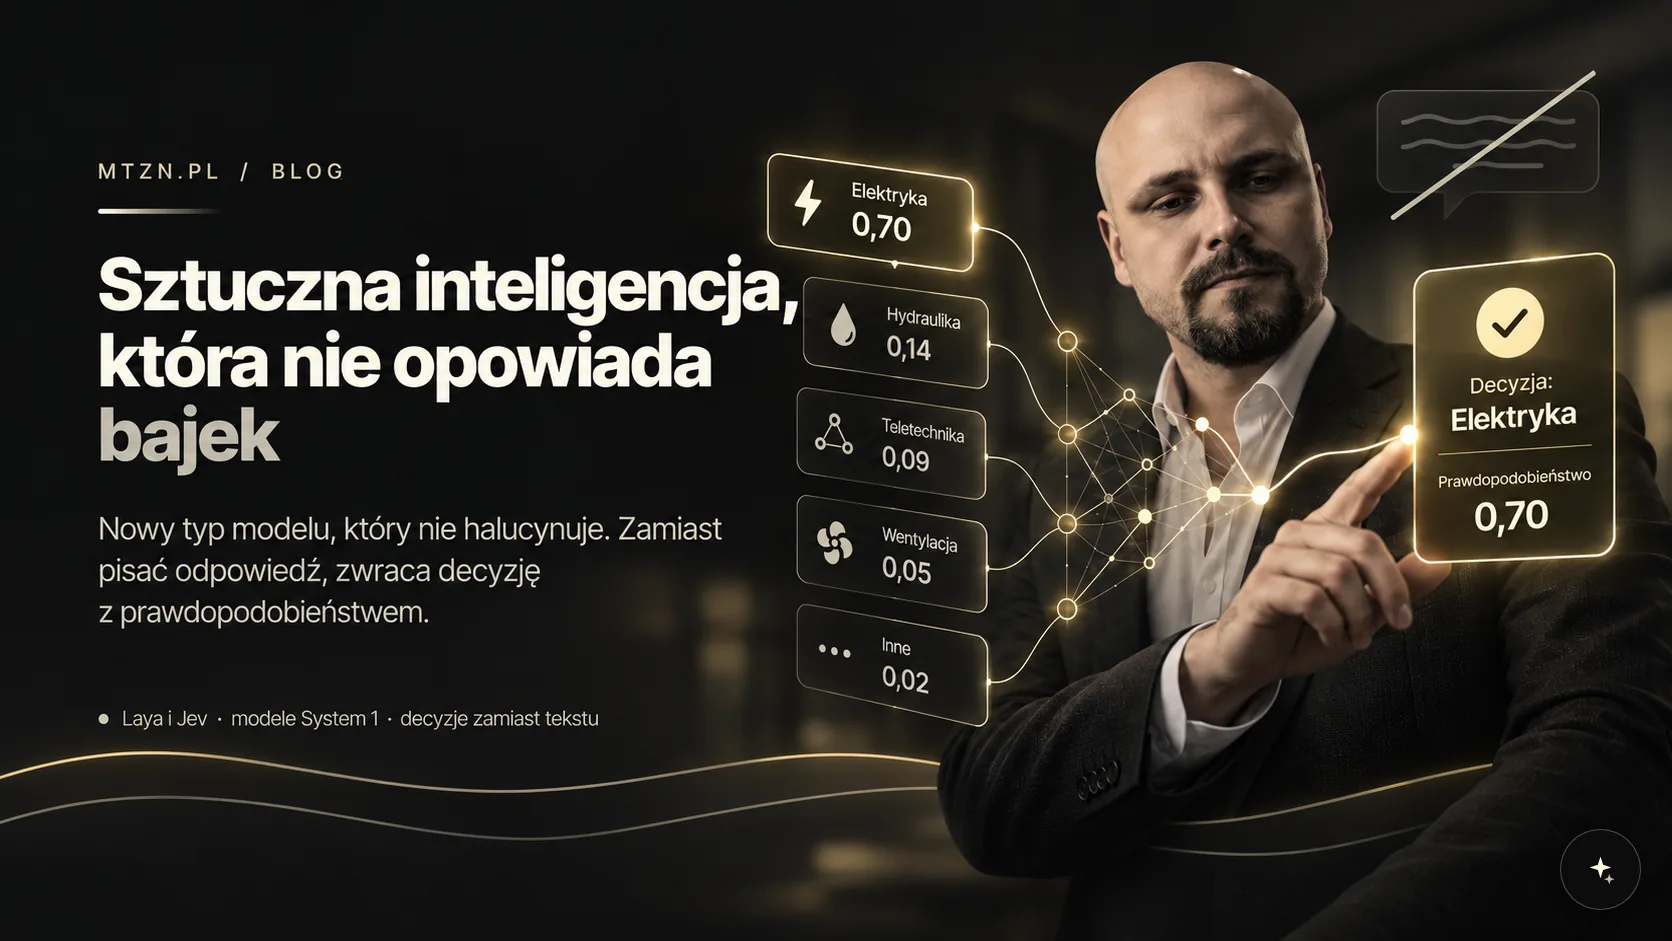
Operator linii pakującej wpisuje do systemu zgłoszenie: "Na linii nr 3 przy przenośniku zwisają niezabezpieczone przewody, można ich dotknąć". Co z tym zrobi dzisiejszy czat? Odpisze uprzejmie, że rozumie powagę sytuacji, wyjaśni, czym grozi porażenie prądem, zaproponuje trzy możliwe przyczyny i na końcu zapyta, czy może w czymś jeszcze pomóc. Wszystko prawda i wszystko na nic, bo system zgłoszeń awarii dla służb utrzymania ruchu nie potrzebuje eseju o przewodach. Potrzebuje trzech odpowiedzi. Która specjalność SUR ma się tym zająć, czy komuś grozi niebezpieczeństwo i jak szybko trzeba zareagować. Najlepiej w postaci liczb, które program zrozumie bez tłumacza.
Przez ostatnie lata przyzwyczailiśmy się, że sztuczna inteligencja potrafi niemal wszystko. Generuje piękne obrazy i całe piosenki, przygotowuje gotowe umowy, pomaga zrozumieć diagnozę lekarską. A mimo to nikt, kto poznał tę technologię wystarczająco dobrze, nie zaufa jej bez sprawdzenia. Powód zna chyba każdy jej fan, a są nim halucynacje. Model układa odpowiedź słowo po słowie, jak student, który na egzaminie ustnym mówi dużo, bo liczy, że gdzieś po drodze trafi, a gdy odpowiedzi nie zna, z tą samą pewnością siebie ją zmyśla. W połowie września w ciągu trzech dni wydarzyły się dwie rzeczy, które pokazują, że można inaczej. 15 września firma TypeSafe AI przedstawiła Jev, model, który w ogóle nie halucynuje. Dostaje opis sytuacji i listę pytań, a zwraca decyzje z prawdopodobieństwami. Taki model nie ma jak opowiadać bajek. Nie dlatego, że nigdy się nie myli, tylko dlatego, że wybiera wyłącznie spośród odpowiedzi, które sam mu podasz, i od razu mówi, na ile jest pewien. Jev jest zamknięty, dostępny przez API z listy oczekujących, bez wag i bez szczegółów budowy. Trzy dni później na GitHubie pojawiła się Laya, otwarty model robiący to samo, na licencji Apache 2.0, z kodem treningowym i gotowymi wagami. W niecały tydzień zebrała ponad dwadzieścia tysięcy gwiazdek. Nic dziwnego, bo pozwala zajrzeć pod maskę czegoś, co konkurencja trzyma w sejfie.
Ponieważ Laya jest otwarta, na jej przykładzie opiszę, jak działa cała grupa modeli tego typu, także zamknięty Jev. Kod, wagi i notatnik treningowy znajdziesz w repozytorium Layi na GitHubie. Przyjrzałem się jej pod kątem dwóch zastosowań, które znam z pracy, czyli klasyfikacji zgłoszeń awarii w zakładzie produkcyjnym i dekretacji faktur. Opiszę po kolei, jak taki model działa, jak się go uczy i gdzie ma sens, a gdzie nie. Obiecuję, że zrozumiesz to bez matematyki. No, prawie bez.
Dlaczego System 1
Nazwa pochodzi od Daniela Kahnemana, który podzielił ludzkie myślenie na dwa tryby. System 2 jest wolny i świadomy, to ten, którym liczysz w pamięci 17 razy 24. System 1 jest szybki i intuicyjny, to ten, którym rozpoznajesz twarz znajomego w tłumie. Doświadczony mistrz utrzymania ruchu czyta "wyciek oleju spod siłownika prasy" i zanim skończy zdanie, wie, że to hydraulika. Czyta "łożysko silnika wentylatora wyje i się grzeje" i wie, że to mechanika. Nie przechodzi w głowie drzewka kilkuset reguł. Dopasowuje nowy przypadek do tysięcy wcześniej widzianych.
Duże modele językowe są w tej analogii Systemem 2. Rozumują, rozpisują, generują, a potem Twój program musi z tego rozpisanego tekstu wydobyć odpowiedź, najczęściej parserem JSON-a, który co jakiś czas zawodzi, bo model postanowił dopisać na końcu życzenia miłego dnia. Model decyzyjny robi co innego. Dostaje stan świata, czyli opis sytuacji, do tego pytanie i możliwe odpowiedzi, a oddaje po jednej liczbie na każdą odpowiedź. Dla zgłoszenia z linii nr 3 mógłby to być wynik, w którym elektryka dostaje 61 procent, automatyka 25, mechanika 12, a hydraulika 2. Nie powstaje żadne zdanie. Powstają cztery liczby.
Pisanie kontra decydowanie
Duży model językowy generuje odpowiedź token po tokenie, model System 1 liczy wszystko w jednym przejściu
I tu jest cały urok, bo z czterema liczbami program radzi sobie doskonale. Jeżeli pewność przekracza ustalony próg, zgłoszenie idzie automatycznie do właściwego zespołu. Jeżeli nie, trafia do człowieka. Żadnego interpretowania, żadnego "moim zdaniem najprawdopodobniej". Laya ma trzy rodzaje takich decyzji. Pierwszy to wybór jednej z kilku opcji, nazywany choice. Drugi to ocena na skali, na przykład pilności od zera do trzech, czyli score. Trzeci to pytanie, czy dane stwierdzenie jest prawdziwe, które twórcy nazwali noul. Na wszystkie pytania model odpowiada naraz, w jednym przebiegu sieci, zamiast generować odpowiedź token po tokenie.
Co się dzieje w środku
Komputer nie wie, co to jest przenośnik. Nie wie też, co to przewód. Pierwszą rzeczą, którą musi zrobić każdy model językowy, jest zamiana tekstu na liczby. Zdanie zostaje pocięte na tokeny, czyli kawałki słów, a każdy token dostaje swój numer. Sam numer niczego jednak nie znaczy, więc w kolejnym kroku każdy token zamienia się w wektor, długi ciąg liczb, w którym zapisane jest jego znaczenie. W głównym modelu Laya takich liczb na jeden token jest 1024. Nie ma w tym jednej liczby "od przenośnika" i drugiej "od zagrożenia". Znaczenie jest rozproszone po wszystkich naraz, trochę jak smak w zupie, której nie da się rozłożyć z powrotem na marchewkę i pietruszkę.
Wektor pojedynczego słowa to jednak za mało, bo słowa zmieniają sens w zależności od sąsiadów. "Przewody zwisają przy przenośniku" i "przewody hydrauliczne prasy pękły przy wymianie narzędzia" to zupełnie inne sytuacje, choć słowo jest to samo. Tym zajmuje się enkoder. W Layi jest to ModernBERT-large, model, który przeczytał ogromne ilości tekstu i nauczył się języka, zanim ktokolwiek pomyślał o usterkach. W odróżnieniu od ChatGPT, który czyta tekst od lewej do prawej i zgaduje następne słowo, BERT patrzy na całe zdanie naraz, w obie strony. Mechanizm, który to umożliwia, nazywa się uwagą. Dla każdego fragmentu tekstu model sprawdza, na które inne fragmenty powinien zwrócić uwagę, żeby go zrozumieć. Przy słowie "przewody" ważne okażą się "zwisają", "przy przenośniku" i "niezabezpieczone", a zupełnie nieważne "zgłoszenie złożono we wtorek". Nikt tego nie programuje ręcznie. Model nauczył się tych zależności sam. Po przejściu przez enkoder każdy token ma już wektor opisujący nie samo słowo, tylko słowo w kontekście całej sytuacji.
Na BERT-cie Laya się nie kończy. Twórcy dołożyli na wierzch głowicę decyzyjną, trenowaną od zera specjalnie do tego zadania. Składa się z dwóch dodatkowych warstw Transformera, niewielkiej sieci oceniającej opcje i jeszcze jednego elementu, o którym za chwilę. Najłatwiej wyobrazić to sobie na przykładzie naszego własnego mózgu. BERT przypomina tę jego część, która odbiera sygnały z oczu i uszu i zamienia je w coś zrozumiałego dla reszty głowy. Widzi pręgowany kształt w trawie, ocenia odległość, kierunek ruchu i rozmiar. Dwie dodatkowe warstwy Transformera działają jak obszary, które nadają tym danym kontekst i podejmują decyzję. Pręgi, dziesięć metrów, zbliża się... rety, tygrys, uciekaj! Pierwsza część dostarcza obraz i zestaw pomiarów, druga rozstrzyga, co one znaczą i co z nimi zrobić. BERT już wie, że kabel przewodzi prąd, rozdzielnica ma coś wspólnego z elektryką, a porażenie z zagrożeniem. Nie ma sensu uczyć go tego od nowa. Trzeba go tylko nauczyć patrzeć na tę wiedzę pod kątem konkretnych decyzji. Dlaczego akurat dwie warstwy, a nie pięć? Tak wskazały eksperymenty. To kompromis między pojemnością a szybkością, a nie prawo natury. Całość ma około 421 milionów parametrów, czyli jak na dzisiejsze standardy to model skromnych rozmiarów.
Najsprytniejszy element to sposób, w jaki model ocenia odpowiedzi. Przed każdą możliwą odpowiedzią Laya wstawia specjalny znacznik [MASK]. Całe wejście wygląda mniej więcej tak: [CLS] choice question: która specjalność? [SEP] [MASK] elektryka [MASK] automatyka [MASK] mechanika [MASK] hydraulika [SEP] opis awarii [SEP]. Po przejściu przez wszystkie warstwy model odczytuje wektor dokładnie w miejscu każdej takiej chorągiewki. Znacznik nie oznacza tu brakującego słowa do uzupełnienia, jak w klasycznym BERT-cie. Jest punktem pomiarowym, fiszką, na której model wystawia ocenę danej odpowiedzi, przeczytawszy wcześniej wszystko inne. A ponieważ odpowiedzi podaje się w zapytaniu, a nie wypala na stałe w modelu, możesz jutro dodać nową specjalność bez żadnego trenowania.
Wektory spod chorągiewek trafiają do małej sieci oceniającej, która z tysiąca liczb robi jedną. Wychodzą surowe oceny w rodzaju 3,8 dla elektryki, 2,7 dla automatyki, 1,4 dla mechaniki i minus 0,8 dla hydrauliki. To jeszcze nie są prawdopodobieństwa. Zamienia je w nie softmax, czyli prosty wzór matematyczny, który każdą ocenę zamienia na potęgę liczby e i dzieli przez sumę takich potęg dla wszystkich opcji. W efekcie wyższe oceny zyskują wyraźną przewagę, a wszystkie wartości mieszczą się między zerem a jedynką i sumują się do jedynki, czyli stu procent. W naszym przykładzie wynik wygląda następująco.
[MASK] elektryka70%[MASK] automatyka23%[MASK] mechanika6%[MASK] hydraulika1%
Cztery liczby zamiast eseju. Program porównuje najwyższą z progiem i od razu wie, co zrobić dalej. I to już cała decyzja, od tekstu do liczby.
Jak model się uczy
Skąd model wie, która odpowiedź jest dobra? Nie wie, dopóki go tego nie nauczysz. Bierzesz historyczne zgłoszenie, na przykład "w szafie sterowniczej linii 2 brak osłony części czynnych", przy którym mistrz zapisał, że to elektryka. Model na początku zgaduje, powiedzmy 22 procent dla elektryki i 49 dla mechaniki. Pomylił się, a że znamy prawidłową odpowiedź, możemy policzyć, jak bardzo. Funkcja błędu nie mówi tylko "źle". Mówi, jak bardzo źle, więc 2 procent dla prawidłowej odpowiedzi kosztuje dużo więcej niż 45.
Potem zaczyna się najważniejsza część, czyli propagacja wsteczna. Wyobraź sobie model jako konsoletę z kilkuset milionami drobnych pokręteł. Każde odrobinę wpływa na wynik. Algorytm idzie od błędu wstecz, przez sieć oceniającą, dwie warstwy decyzyjne i cały enkoder, i dla każdego pokrętła liczy, w którą stronę je przekręcić, żeby następnym razem pomylić się trochę mniej. Przekręca delikatnie i bierze kolejny przykład. "Panel operatorski nie łączy się ze sterownikiem PLC", prawidłowo automatyka, błąd, poprawka. "Przenośnik rolkowy piszczy i szarpie przy rozruchu", prawidłowo mechanika, błąd, poprawka. I tak tysiące razy, aż sieć sama ułoży sobie przestrzeń znaczeń tak, że podobne przypadki prowadzą do podobnych decyzji. W praktyce przykłady nie idą przez sieć pojedynczo, tylko wsadami. W notatniku treningowym Layi wsad ma 64 przykłady, sieć liczy dla nich błąd naraz, a w drogę powrotną rusza jego średnia. Warto też wiedzieć, że trenowany jest cały model, łącznie z BERT-em, a nie tylko nakładka na wierzchu.
Sieć Laya od środka: wsad płynie w prawo, gradient wraca w lewo
Kremowe strzałki to przejście w przód, khaki to propagacja wsteczna podczas treningu
Jeżeli chcesz zobaczyć, co dokładnie znaczy przekręcenie pokrętła, poniżej ten sam rachunek na sieci, która ma dwie wagi zamiast czterystu milionów. Liczby są prawdziwe, możesz je sprawdzić na kalkulatorze.
Propagacja wsteczna w miniaturze, z prawdziwymi liczbami
Dwie wagi zamiast 421 milionów, ale mechanizm jest dokładnie ten sam
Na tym etapie Laya robi coś ciekawszego niż zwykły klasyfikator. Twórcy Jev nazwali swoją metodę RLCD, od uczenia ze wzmocnieniem dla skalibrowanych decyzji, a Laya przejęła nazwę i opisała, co się za nią kryje. Najprościej wyjaśnić to na przykładzie bukmachera. Bukmacher, który na mecz Polska kontra Niemcy daje Polsce 65 procent, a za każdym razem wygrywają Niemcy, szybko zbankrutuje. Ale zbankrutuje też taki, który daje 99 procent temu, kto akurat wygrał, bo przy pierwszej niespodziance straci wszystko. Model dostaje nagrodę liczoną regułą, która premiuje uczciwość. Za 99 procent pewności przy błędzie kara jest bolesna, za ostrożne 55 do 45 łagodna. Najwięcej zarabia ten, kto mówi dokładnie tyle, ile wie. W praktyce oznacza to, że jeżeli model tysiąc razy powie "80 procent", to powinien mieć rację mniej więcej osiemset razy.
Pętla treningu
Przejście w przód, porównanie, propagacja wsteczna, aktualizacja wag, i od nowa
Tu pierwsza uwaga, której w entuzjastycznych opisach nie przeczytasz. Sami autorzy Layi piszą w repozytorium, że oba udostępnione modele są w stanie fabrycznym przesadnie pewne siebie. Błąd kalibracji spada do przyzwoitego poziomu dopiero po dopasowaniu tak zwanej temperatury, czyli prostego mnożnika, który stroi prawdopodobieństwa na odłożonym zbiorze danych. Wersja wielojęzyczna nie ma jej dopasowanej wcale. Dopóki tego nie zrobisz, jej procenty są ozdobnikiem. Druga uwaga dotyczy wspomnianego elementu głowicy, który miał decydować, czy działać sam, czy przekazać sprawę człowiekowi. Według autorów na razie nie niesie żadnej użytecznej informacji i prawie zawsze pokazuje, że można działać. Bramkować trzeba po pewności samej odpowiedzi. Trzecia jest najważniejsza. Bazowa Laya na zbiorze testowym z decyzjami biznesowymi trafia w 36 procentach przypadków, przy 32 procentach za losowe zgadywanie. Po dostrojeniu na tych samych typach zadań trafia w 77 procentach. A mówimy o niewielkim zbiorze, bo model dostrajano na około 1200 przypadkach z 6000 decyzji, a sprawdzano na 400 przypadkach z 2000 decyzji. Przy bogatszym zbiorze danych z Twojej branży można oczekiwać istotnego wzrostu trafności. Cała wartość bierze się więc z dostrajania. Laya nie jest gotowym mózgiem, który wdrożysz w firmie od ręki. Jest szybką bazą, którą trzeba nauczyć Twojego procesu. Autorzy piszą to zresztą uczciwie wprost i należy im się za to szacunek, bo w tej branży skromność jest towarem deficytowym.
Trafność na zbiorze decyzji biznesowych
Pomiar autorów Laya, 400 przypadków, 2000 decyzji
Dane to doświadczenie zawodowe
Skoro wszystko rozstrzyga dostrajanie, to wszystko rozstrzygają dane. Jeżeli chcesz zbudować model dla utrzymania ruchu, nie potrzebujesz biblioteki podręczników o maszynach, bo BERT ogólną wiedzę już ma. Potrzebujesz zapisu decyzji podejmowanych przez ekspertów. Opis sytuacji, pytanie, możliwe odpowiedzi i to, co naprawdę postanowił mistrz utrzymania ruchu. Z jednego zgłoszenia o przewodzie przy przenośniku powstaje kilka przykładów naraz, bo ktoś musiał zdecydować o specjalności, o zagrożeniu, o pilności i o tym, czy w ogóle wiadomo wystarczająco dużo, żeby kogokolwiek wysyłać.
Przy okazji faktur pojawiło się pytanie, które okazało się kluczowe. Czy uczyć model nazwisk pracowników i nazw podwykonawców? Kusi, bo przecież jeżeli awarie elektryczne na linii nr 3 zawsze obsługuje pan Marek, to najprościej nauczyć model, że luźny przewód to pan Marek. Tyle że pan Marek bywa na urlopie i ma wtedy zastępstwo, a zewnętrzny podwykonawca od automatyki za jakiś czas może się zmienić. Za każdym razem model trzeba by trenować od nowa. Zasada, którą należy przyjąć, brzmi tak. Semantyka idzie do modelu, a specyfika firmy, jej ludzi i kontrahentów zostaje poza nim. Model uczy się, że to problem elektryczny. Zwykły program sprawdza w grafiku i umowach, który elektryk ma dziś dyżur na tej zmianie, kto go zastępuje albo który podwykonawca odpowiada za ten obszar, i tam wysyła zgłoszenie. Przy fakturach jest identycznie. Model rozpoznaje, że kupiono części zamienne do maszyn, a konfiguracja klienta decyduje, na które konto to zaksięgować. Korekta księgowej trafia od razu do pamięci firmy, bez żadnego trenowania, a nowy dostawca nie wymaga nowego modelu. Wiedza w wagach zostaje trwała, bo dotyczy tego, jak działa świat, a nie tego, kto akurat ma dyżur.
Drugą rzeczą, którą trzeba mieć w danych, są przypadki niejednoznaczne. Gdyby wszystkie przykłady brzmiały jak "nie działa gniazdko 230 V", model nauczyłby się tylko prostych skojarzeń. Prawdziwa praca zaczyna się przy "obok przenośnika zwisa przewód", bo to może być zasilanie silnika, sterowanie, przewód czujnika, instalacja tymczasowa po przezbrojeniu albo stary, nieczynny kabel, o którym wszyscy zapomnieli. Najlepiej, jeżeli ekspert może w takim miejscu powiedzieć, że to w 45 procentach elektryka, w 35 automatyka, a w 20 mechanika, zamiast udawać stuprocentową pewność. Laya potrafi się uczyć z takich rozkładów, a nie tylko z jednej prawidłowej odpowiedzi. W prawdziwym świecie ekspert też często nie jest pewien, a model, który się tego nauczy, będzie wiedział, kiedy sam powinien zawołać człowieka.
Ile to kosztuje? Tu czekała mnie miła niespodzianka. Dostrojenie takiego modelu jest tanie, jak na tę branżę wręcz zaskakująco tanie, bo cała seria eksperymentów mieści się w budżecie, który duża firma IT wydaje na kawę. Znacznie cenniejsze są dane. Na próbę wystarczy kilka tysięcy sprawdzonych decyzji, a do pracy produkcyjnej przydają się dziesiątki tysięcy. Brzmi groźnie, ale jedno zgłoszenie awarii to od razu kilka decyzji, bo ktoś ustalił specjalność, ocenił zagrożenie, nadał pilność i zdecydował, czy zatrzymać linię. Jeżeli więc w Twojej fabryce, a może na Twoich budowach, takie zgłoszenia zbierane są od lat, masz w szufladzie wielką przewagę nad konkurencją. Model można pobrać z GitHuba w pięć minut. Dziesięciu lat decyzji Twoich ludzi nie da się pobrać znikąd.
Gdzie to pasuje, a gdzie nie
Model decyzyjny nie powinien robić wszystkiego. Najlepiej widać to na całym obiegu zgłoszenia. Operator wpisuje awarię na panelu przy linii, model w kilkadziesiąt milisekund ocenia specjalność, zagrożenie i pilność, a potem do pracy wchodzi zwykłe oprogramowanie. Jeżeli zagrożenie jest prawdopodobne, od razu powiadamia mistrza zmiany. Sprawdza w grafiku, kto z SUR ma dyżur w tej specjalności albo kto go zastępuje, zakłada zlecenie i ustawia termin reakcji. Model robi to, w czym tradycyjne programowanie jest bezradne, czyli rozumie nieprecyzyjny ludzki język. Program robi to, w czym jest świetny, czyli pilnuje twardych reguł i wykonuje działania. Duży model językowy nadal ma swoje miejsce, ale na końcu lejka, przy wyjątkach, których nikt wcześniej nie widział, przy długich dokumentach i przy pisaniu wiadomości do podwykonawcy. Przy fakturach taki lejek mógłby wyglądać tak, że ze stu tysięcy dokumentów większość księguje się automatycznie, kilkanaście tysięcy obsługują reguły, kilka tysięcy analizuje duży model, a do księgowej trafia kilkaset naprawdę trudnych. Nie chodzi o to, żeby zastąpić czaty. Chodzi o to, żeby nie wołać profesora do zadania z tabliczki mnożenia.
Miejsce Layi w obiegu zgłoszenia
Model rozumie język, program pilnuje reguł, człowiek zajmuje się wyjątkami
Rozbijanie problemu na małe decyzje ma jeszcze jedną zaletę. Pytanie "co zrobić z tym zgłoszeniem?" jest ogromne i nieostre. Pytania o to, co zostało uszkodzone, do której specjalności należy, czy grozi niebezpieczeństwem i czy informacji jest dość, są małe i sprawdzalne. Każde może mieć własny próg pewności. Przy dużej liczbie kategorii lepiej schodzić piętrami, najpierw specjalność, potem maszyna, potem konkretny podzespół, niż dawać modelowi osiemdziesiąt opcji naraz. To nie jest kwestia gustu. Laya przy wielu opcjach wyraźnie słabnie, bo każda odpowiedź dostaje coraz mniej miejsca w wejściu. Na zbiorze z 77 kategoriami bankowymi trafia w 43 procentach, podczas gdy Jev, według danych jego twórców, w 87. Przy kilku opcjach sytuacja się odwraca.
Jeżeli nie masz jeszcze tysięcy oznaczonych przykładów, nie musisz od razu trenować. Na start wystarczy router semantyczny, czyli porównywanie opisu zgłoszenia z kilkudziesięcioma wzorcowymi przykładami. Działa od pierwszego dnia i przy okazji zbiera poprawki ludzi. Gdy tych poprawek uzbiera się kilka tysięcy, dostrajasz Layę, która uchwyci zależności, jakich proste porównywanie nie widzi. Router może wtedy zostać jako sito zawężające listę kandydatów, a model wybiera spośród nich.
Zostaje język. Główna Laya jest trenowana po angielsku. Wersja wielojęzyczna działa szybciej, ale poza angielskim radzi sobie przeciętnie, a jej procenty, jak wspomniałem, nie są skalibrowane. Dla polskich zastosowań rozsądniej byłoby podmienić enkoder na polski ModernBERT udostępniony przez Ośrodek Przetwarzania Informacji, który przeczytał kilkadziesiąt miliardów polskich tokenów, i dopiero na nim zbudować głowicę decyzyjną. To więcej pracy, ale architektura Layi na to pozwala, bo głowica nie jest przywiązana do konkretnego enkodera.
Najciekawsze w całej tej historii nie jest to, że model klasyfikuje tekst. Klasyfikatory istnieją od lat. Ciekawe jest połączenie mocnego enkodera, który już zna język, głowicy uczonej podejmowania decyzji, odpowiedzi definiowanych w zapytaniu i nagrody za uczciwą pewność. Z tego wychodzi coś, co przypomina nowy rodzaj funkcji w programowaniu. Dajesz jej sytuację, a ona oddaje decyzję razem z informacją, na ile jest jej pewna. Zgłoszenie awarii zamienia się w specjalność, protokół przeglądu w "zgodny" albo "niezgodny", opis w "wymaga zatrzymania linii" albo "nie wymaga", faktura w kategorię kosztu. A że jedna firma trzyma taki model w sejfie, a druga trzy dni później oddała podobny wszystkim, to znów wracamy do pytania, które zadaję na tym blogu nie pierwszy raz. Kto jutro będzie właścicielem decyzji podejmowanych w Twojej firmie? Na szczęście tym razem ktoś odpowiedział, zanim zdążyłem zapytać.
Model decyzyjny nie zachwyci Cię elokwencją. Za to zamieni nieprecyzyjny język człowieka w liczbę, z którą oprogramowanie od razu wie, co zrobić. A Twoje doświadczenie, zapisane w danych, stanie się częścią jego intuicji.
Stan repozytorium Laya i informacji o Jev na 24 września 2026 roku.
