
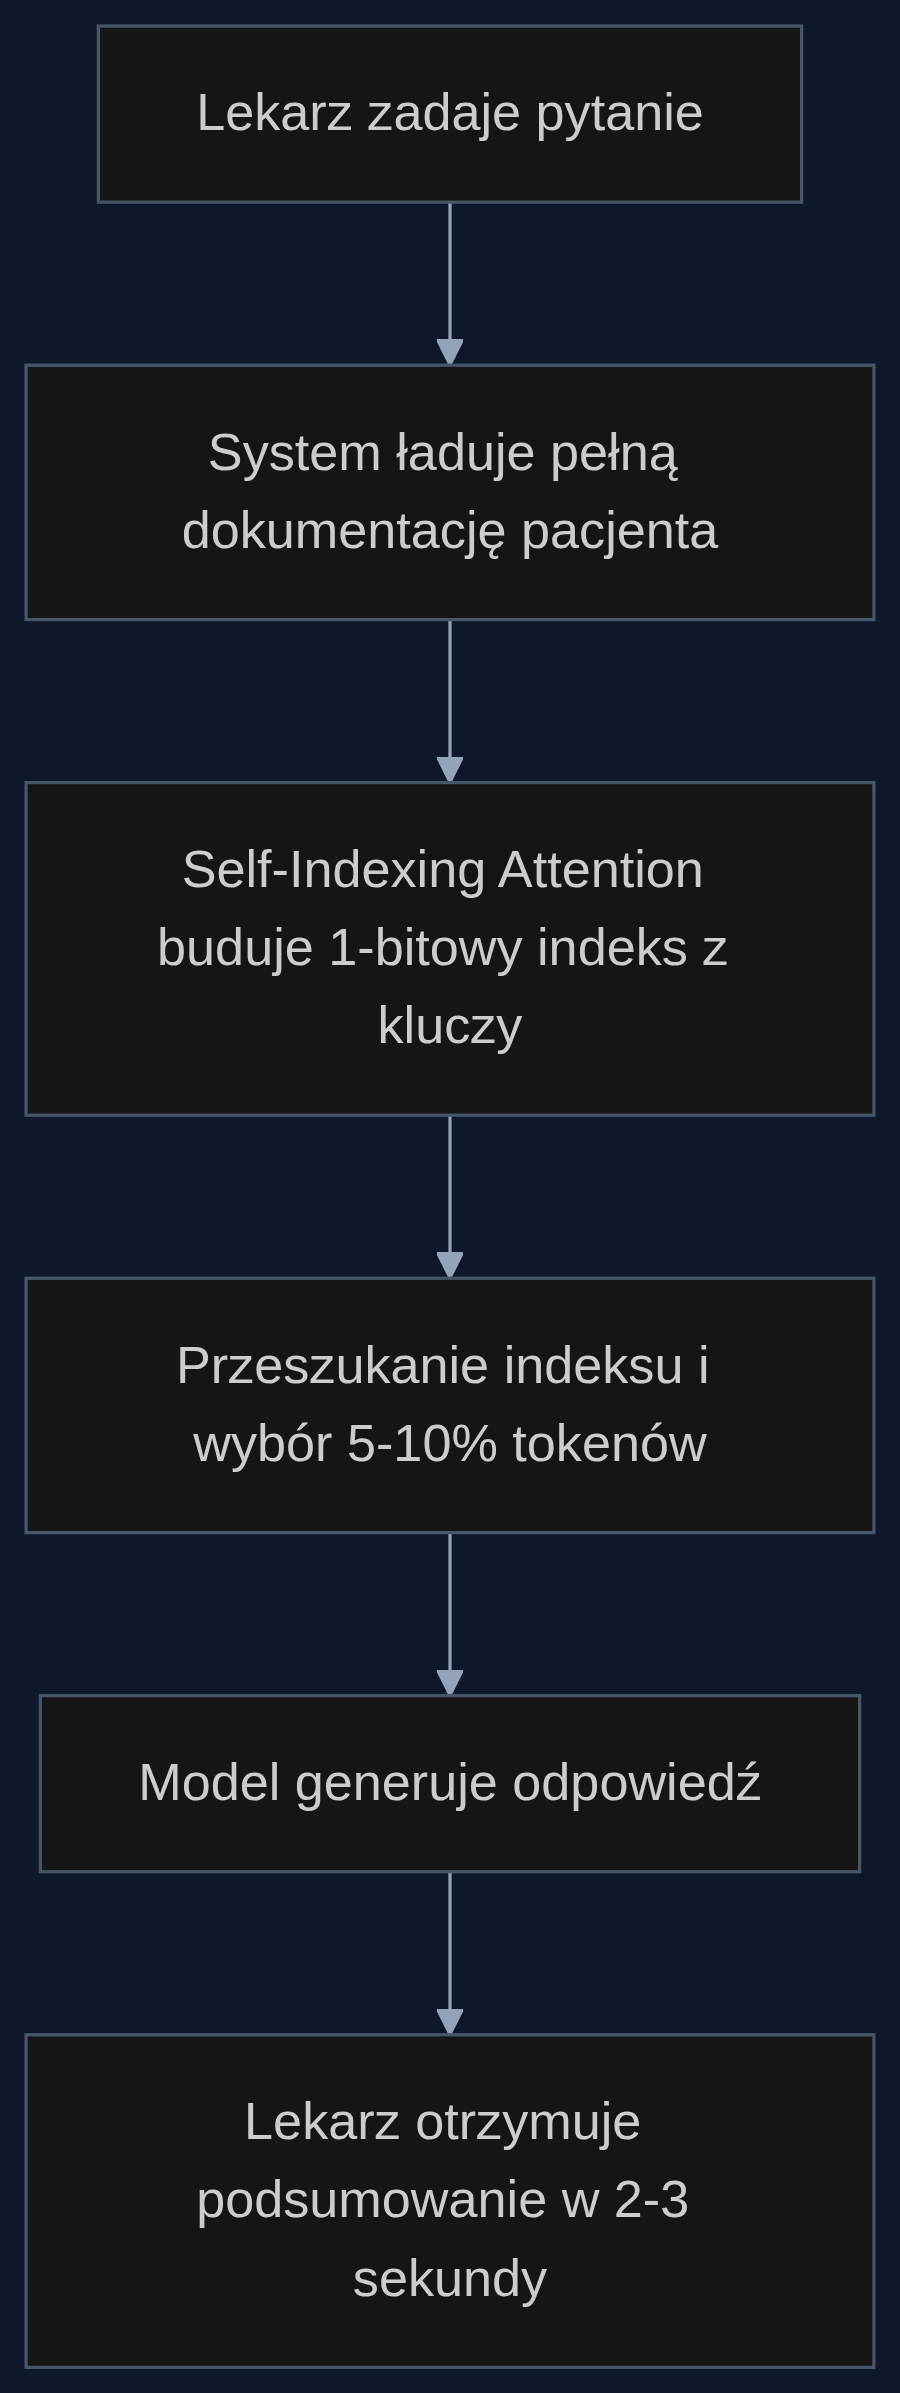
Lekarz rodzinny przed wizytą ma 15 minut. Pacjent z przewlekłymi schorzeniami ma w systemie 800 wpisów z ostatnich 10 lat – wizyty, wyniki badań, uwagi specjalistów. Przeczytanie tego zajmuje 8 minut, więc na rozmowę zostaje 7. Self-Indexing Attention pozwala dużemu modelowi językowemu przeszukać całą tę dokumentację w 3 sekundy i podać odpowiedź na konkretne pytanie, bez żadnego dodatkowego trenowania.
Problem nie w ilości danych, tylko w czasie dostępu
Elektroniczna dokumentacja medyczna pacjenta to dziś często tysiące ustrukturyzowanych i nieustrukturyzowanych wpisów. Lekarz nie potrzebuje przeczytać wszystkiego – musi znaleźć konkretne informacje: jakie leki na nadciśnienie pacjent brał w 2019 roku, czy był kiedykolwiek hospitalizowany z powodu reakcji alergicznej na anestezję, jakie wyniki morfologii miał przed ostatnim zabiegiem. Standardowe modele językowe, nawet te wytrenowane na danych medycznych (np. Meditron, BioBERT), przy długich kontekstach zwalniają lawinowo – każdy kolejny token odpowiedzi wymaga przejrzenia wszystkich poprzednich tokenów zapytania. Dla 50 tysięcy słów czas generowania podsumowania potrafi sięgnąć 2-3 minut, co w gabinecie dyskwalifikuje narzędzie.
Jak Self-Indexing Attention przyspiesza model bez zmiany jego wag
Metoda opisana w paperze Xu Yanga i zespołu (2025) sprowadza się do prostego triku: klucze mechanizmu atencji, które normalnie są wektorami liczb zmiennoprzecinkowych, zamienia się na 1-bitowe znaki (plus/minus) za pomocą dyskretnej transformacji kosinusowej (DCT). Te znaki tworzą globalny indeks tokenów w całej sekwencji. Gdy lekarz zadaje pytanie, model nie analizuje każdego słowa w dokumentacji, tylko przeszukuje indeks bitowy, wybierając 5-10% tokenów, które mają największą szansę być istotne dla odpowiedzi. Resztę pomija. Efekt: operator atencji wykonuje nawet 10 razy mniej operacji, a jakość odpowiedzi pozostaje niemal identyczna jak przy pełnym przetwarzaniu. Co kluczowe dla IT w szpitalach: nie trzeba trenować nowego modelu medycznego od zera. Wystarczy podmienić warstwę atencji w istniejącym modelu (np. wdrożonym już LLM wspierającym lekarzy) na wersję Self-Indexing, co w praktyce oznacza podmianę kilku plików w API serwującym model.
Scenariusz: oddział kardiologii w szpitalu wojewódzkim
Wyobraźmy sobie oddział z 20 łóżkami i 8 lekarzami. Każdy przyjęty pacjent ma za sobą średnio 15-letnią historię leczenia, zapisaną w systemie HIS w formie notatek, wypisów i wyników. Przed obchodem lekarz otwiera tablet, dyktuje lub wpisuje pytanie: "Podsumuj zmiany w leczeniu nadciśnienia u tego pacjenta od 2020 roku, uwzględnij skuteczność i działania niepożądane". Asystent AI z włączonym Self-Indexing Attention przeszukuje całość dokumentacji – łącznie 120 tysięcy tokenów – w 2,8 sekundy. Odpowiedź to akapit tekstu z odnośnikami do konkretnych dat i wpisów. Lekarz widzi, że w marcu 2021 zamieniono peryndopryl na telmisartan z powodu kaszlu, a ciśnienie po zmianie było stabilne. Decyzja terapeutyczna zapada od razu. W analogicznym systemie bez tej metody czas oczekiwania wyniósłby 90 sekund, co sprawia, że lekarz woli kartkować papierową dokumentację.
Korzyści namacalne i wyliczenia ROI
W powyższym oddziale kardiologii każdy lekarz zadaje średnio 12 pytań dziennie do systemu. Oszczędność 87 sekund na zapytanie daje 17 minut dziennie na lekarza, czyli łącznie 136 minut dla oddziału. W skali miesiąca (22 dni robocze) to 50 godzin, które można przeznaczyć na kontakt z pacjentem, a nie na wertowanie ekranu. Przekładając to na pieniądze: godzina pracy lekarza kosztuje szpital około 120 zł, więc roczna oszczędność to prawie 72 tysiące złotych na jednym oddziale. Dla sieci 5 szpitali z 15 oddziałami wewnętrznymi kwota sięga już pół miliona złotych rocznie. Do tego dochodzi redukcja błędów: gdy zapytanie o alergie przed zabiegiem zwraca odpowiedź w 3 sekundy, anestezjolog nie opiera się na niepełnych danych z wywiadu. Według badania opublikowanego w 'BMJ Quality & Safety' (2023) pominięcie informacji o alergii w historii pacjenta odpowiada za 7% zdarzeń niepożądanych w anestezji.
Od czego zacząć pilotaż
Pilotaż najlepiej przeprowadzić na jednym oddziale i na historycznych danych pacjentów, którzy wyrazili zgodę na przetwarzanie. Zespół IT udostępnia API do modelu (może to być ten sam model, który już obsługuje chatboty dla pacjentów) z wpiętą biblioteką Self-Indexing Attention – autorzy udostępnili implementację na GitHubie. Przez pierwsze dwa tygodnie lekarze ręcznie porównują odpowiedzi modelu z pełnym przeszukaniem dokumentacji, żeby potwierdzić, że żadna istotna informacja nie została pominięta. Z testów na benchmarku LongBench przy 5% gęstości atencji strata dokładności wynosi poniżej 2 punktów procentowych w zadaniach Q&A, co w kontekście medycznym jest akceptowalne przy weryfikacji przez człowieka. Potem można rozszerzyć na pozostałe oddziały, integrując z systemem HIS za pomocą standardowych interfejsów HL7 FHIR.
- Skrócenie czasu odpowiedzi z 90 sekund do 3 sekund na jedno zapytanie kliniczne
- Wdrożenie na istniejących modelach medycznych bez trenowania – wystarczy podmiana warstwy atencji
- Dokładność na poziomie 98% pełnej atencji przy przetwarzaniu zaledwie 5% tokenów
Informacje o artykule
Ten artykuł powstał w oparciu o paper naukowy opublikowany w serwisie arXiv.
Paper: Self-Indexing Attention for Compression-Compatible Sparse Long-Context LLM Inference
Autorzy: Xu Yang, Jiapeng Zhang, Zhangke, Changjian Chen, Yuxin Chen i in.
Sparse long-context inference requires efficient token retrieval in both prefill and decode. Existing methods often use different retrieval strategies for the two stages, preventing one retrieval representation from being reused throughout inference. We propose Self-Indexing Attention, a training...
arXiv: arxiv.org/abs/2609.13205
Artykuł wygenerowany ze wsparciem sztucznej inteligencji.

