
Raport roczny spółki giełdowej to często 300-400 stron gęstego tekstu. Analityk, który musi go przeczytać i wyłuskać kluczowe informacje o ryzyku, strategii czy trendach, spędza nad tym kilka godzin. Jeśli ma pod opieką 20 spółek, tydzień pracy znika. Nowa metoda o nazwie Self-Indexing Attention pozwala modelom językowym przeszukiwać takie dokumenty w kilka sekund, bez utraty jakości odpowiedzi.
Problem: setki stron, mało czasu
W finansach czas to dosłownie pieniądz. Analitycy giełdowi i zarządzający funduszami toną w dokumentach: raporty roczne (10-K), prospekty emisyjne, sprawozdania zarządu. Każdy z nich może mieć kilkaset stron. Tradycyjne metody analizy – czytanie linijka po linijce albo proste wyszukiwanie słów kluczowych – są powolne i podatne na przeoczenia. Kontekstowe pytania, takie jak 'jak zmieniło się ryzyko walutowe w porównaniu do poprzedniego kwartału?', wymagają zrozumienia całego dokumentu. Standardowy model językowy (LLM) musiałby przetworzyć cały tekst, co przy długich kontekstach trwa wieki i kosztuje fortunę w zasobach obliczeniowych.
Technologia: inteligentny indeks w modelu językowym
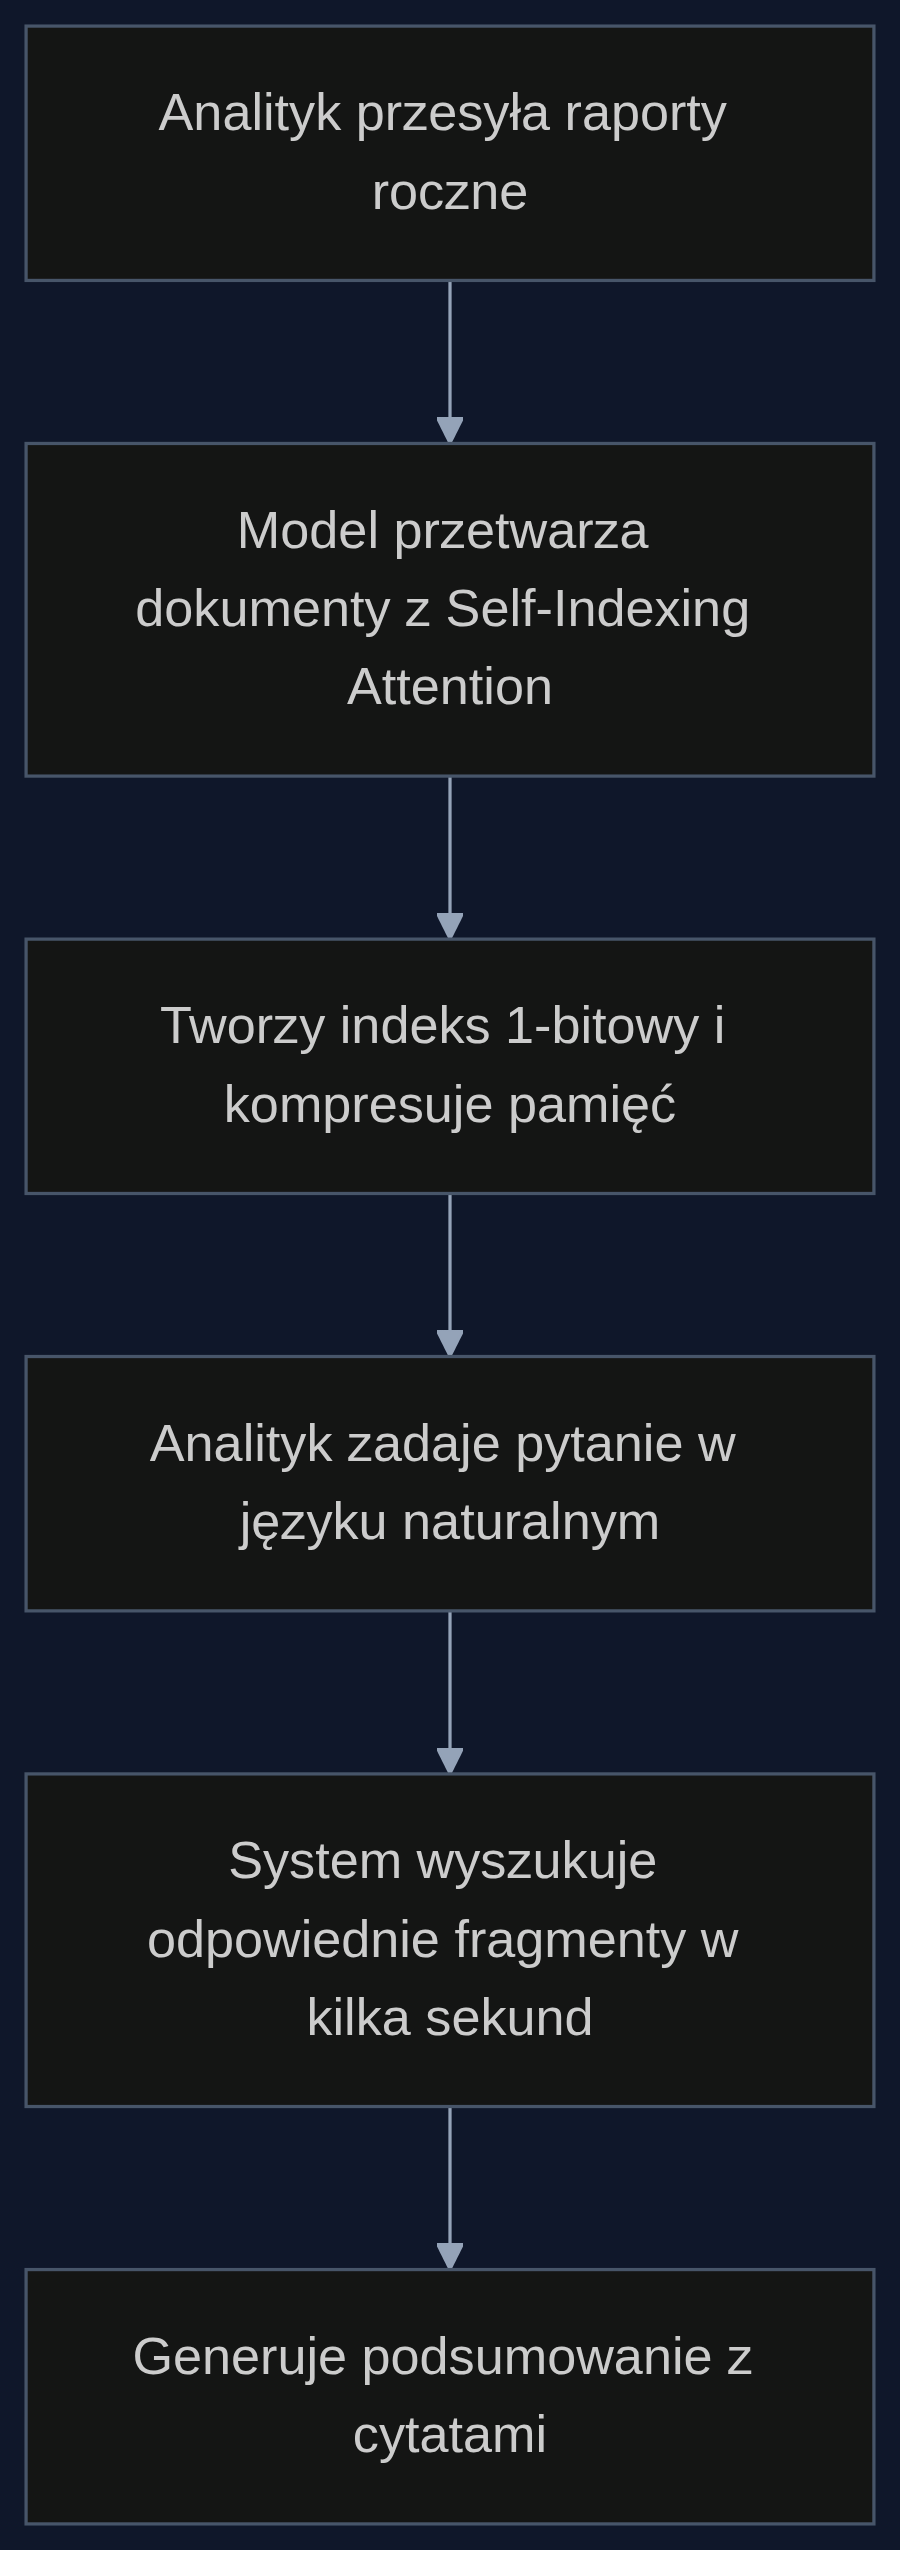
Self-Indexing Attention to metoda, która działa na istniejących modelach (np. Llama, Mistral) bez dodatkowego treningu. W uproszczeniu, zamienia ona wewnętrzne reprezentacje tekstu na coś w rodzaju 1-bitowego indeksu. Model nie musi czytać każdego słowa z równą uwagą – szybko identyfikuje fragmenty najbardziej istotne dla zadanego pytania i pomija resztę. Dzięki temu analiza całego raportu rocznego trwa kilka sekund, a nie minut. Co ważne, jakość odpowiedzi pozostaje bliska pełnej, gęstej atencji, co potwierdzają testy na benchmarkach LongBench i RULER. Przyspieszenie na etapie wstępnego przetwarzania (prefill) sięga 6,1 razy, a przy generowaniu odpowiedzi (decode) nawet 10,3 razy. To nie jest teoretyczna ciekawostka – to praktyczne narzędzie, które od razu można podłączyć do firmowego chatbota analitycznego.
Scenariusz: analityk zadaje pytanie, system odpowiada w sekundy
Weźmy średniej wielkości fundusz inwestycyjny monitorujący 50 spółek. Po publikacji wyników kwartalnych zespół analityków dostaje gorączkowe zadanie: które spółki zwiększyły ekspozycję na ryzyko stopy procentowej? Gdzie zmieniła się strategia zarządzania długiem? Jak kształtują się trendy marż w poszczególnych segmentach? Tradycyjnie to godziny wertowania PDF-ów. Z modelem wyposażonym w Self-Indexing Attention analityk wpisuje pytanie w języku naturalnym: 'Pokaż mi wszystkie fragmenty dotyczące ryzyka walutowego w raportach spółek budowlanych za ostatnie półrocze, z zaznaczeniem, czy ryzyko wzrosło czy spadło'. System przeszukuje setki stron równolegle – bo przyspieszony prefill pozwala ładować wiele dokumentów naraz – i w kilka sekund zwraca podsumowanie z cytatami. Analityk nie traci czasu na szukanie, tylko od razu przechodzi do interpretacji i decyzji.
Korzyści i zwrot z inwestycji
Oszczędność czasu to nie tylko niższe koszty pracy, ale przede wszystkim szybsze decyzje inwestycyjne. Jeśli fundusz podejmie decyzję o kupnie lub sprzedaży akcji o dwie godziny szybciej niż konkurencja, zyskuje realną przewagę. Szacuje się, że w zespole pięciu analityków automatyzacja wstępnej analizy raportów może uwolnić około 30% ich czasu. To jak zatrudnienie dodatkowej osoby bez dodatkowych kosztów. Dodatkowo, metoda nie wymaga kosztownego douczania modeli – działa od ręki na popularnych architekturach. Kompatybilność z istniejącymi technikami kompresji pamięci (KV-cache) oznacza, że można ją wdrożyć bez rozbudowy infrastruktury serwerowej. Oczywiście, żaden system nie zastąpi ludzkiego osądu, ale odciążenie od żmudnego przeszukiwania dokumentów pozwala skupić się na tym, co naprawdę ważne: interpretacji niuansów i podejmowaniu decyzji.
Podsumowanie: szybciej znaczy lepiej
Self-Indexing Attention to nie kolejny buzzword z konferencji AI. To konkretna metoda, która już teraz może przyspieszyć pracę z długimi dokumentami finansowymi. Dla instytucji, które żyją z informacji, to szansa na szybsze i trafniejsze decyzje. Jeśli zarządzasz zespołem analityków, warto przetestować to rozwiązanie na próbce 10 raportów i porównać czas uzyskania odpowiedzi z tradycyjnym podejściem. Różnica będzie widoczna gołym okiem.
- Redukcja czasu analizy raportu z godzin do kilku sekund
- Możliwość równoległego przetwarzania dziesiątek dokumentów jednocześnie
- Jakość odpowiedzi zbliżona do pełnej analizy, bez ryzyka przeoczenia istotnych informacji
- Brak konieczności dodatkowego trenowania modeli – działa od ręki
Informacje o artykule
Ten artykuł powstał w oparciu o paper naukowy opublikowany w serwisie arXiv.
Paper: Self-Indexing Attention for Compression-Compatible Sparse Long-Context LLM Inference
Autorzy: Xu Yang, Jiapeng Zhang, Zhangke, Changjian Chen, Yuxin Chen i in.
Sparse long-context inference requires efficient token retrieval in both prefill and decode. Existing methods often use different retrieval strategies for the two stages, preventing one retrieval representation from being reused throughout inference. We propose Self-Indexing Attention, a training...
arXiv: arxiv.org/abs/2609.13205
Artykuł wygenerowany ze wsparciem sztucznej inteligencji.

