
Przegląd systematyczny 40 badań klinicznych zamiast dwóch tygodni zajmuje dziś jeden dzień, jeśli zespół ma do dyspozycji model językowy, który faktycznie radzi sobie z długimi tekstami. Problem w tym, że standardowa atencja po wrzuceniu piętnastu pełnych artykułów po prostu dławi się obliczeniami. Self-Indexing Attention, metoda z 2024 roku, usuwa to wąskie gardło bez dodatkowego trenowania modelu.
Technologia w kontekście przeglądów literatury
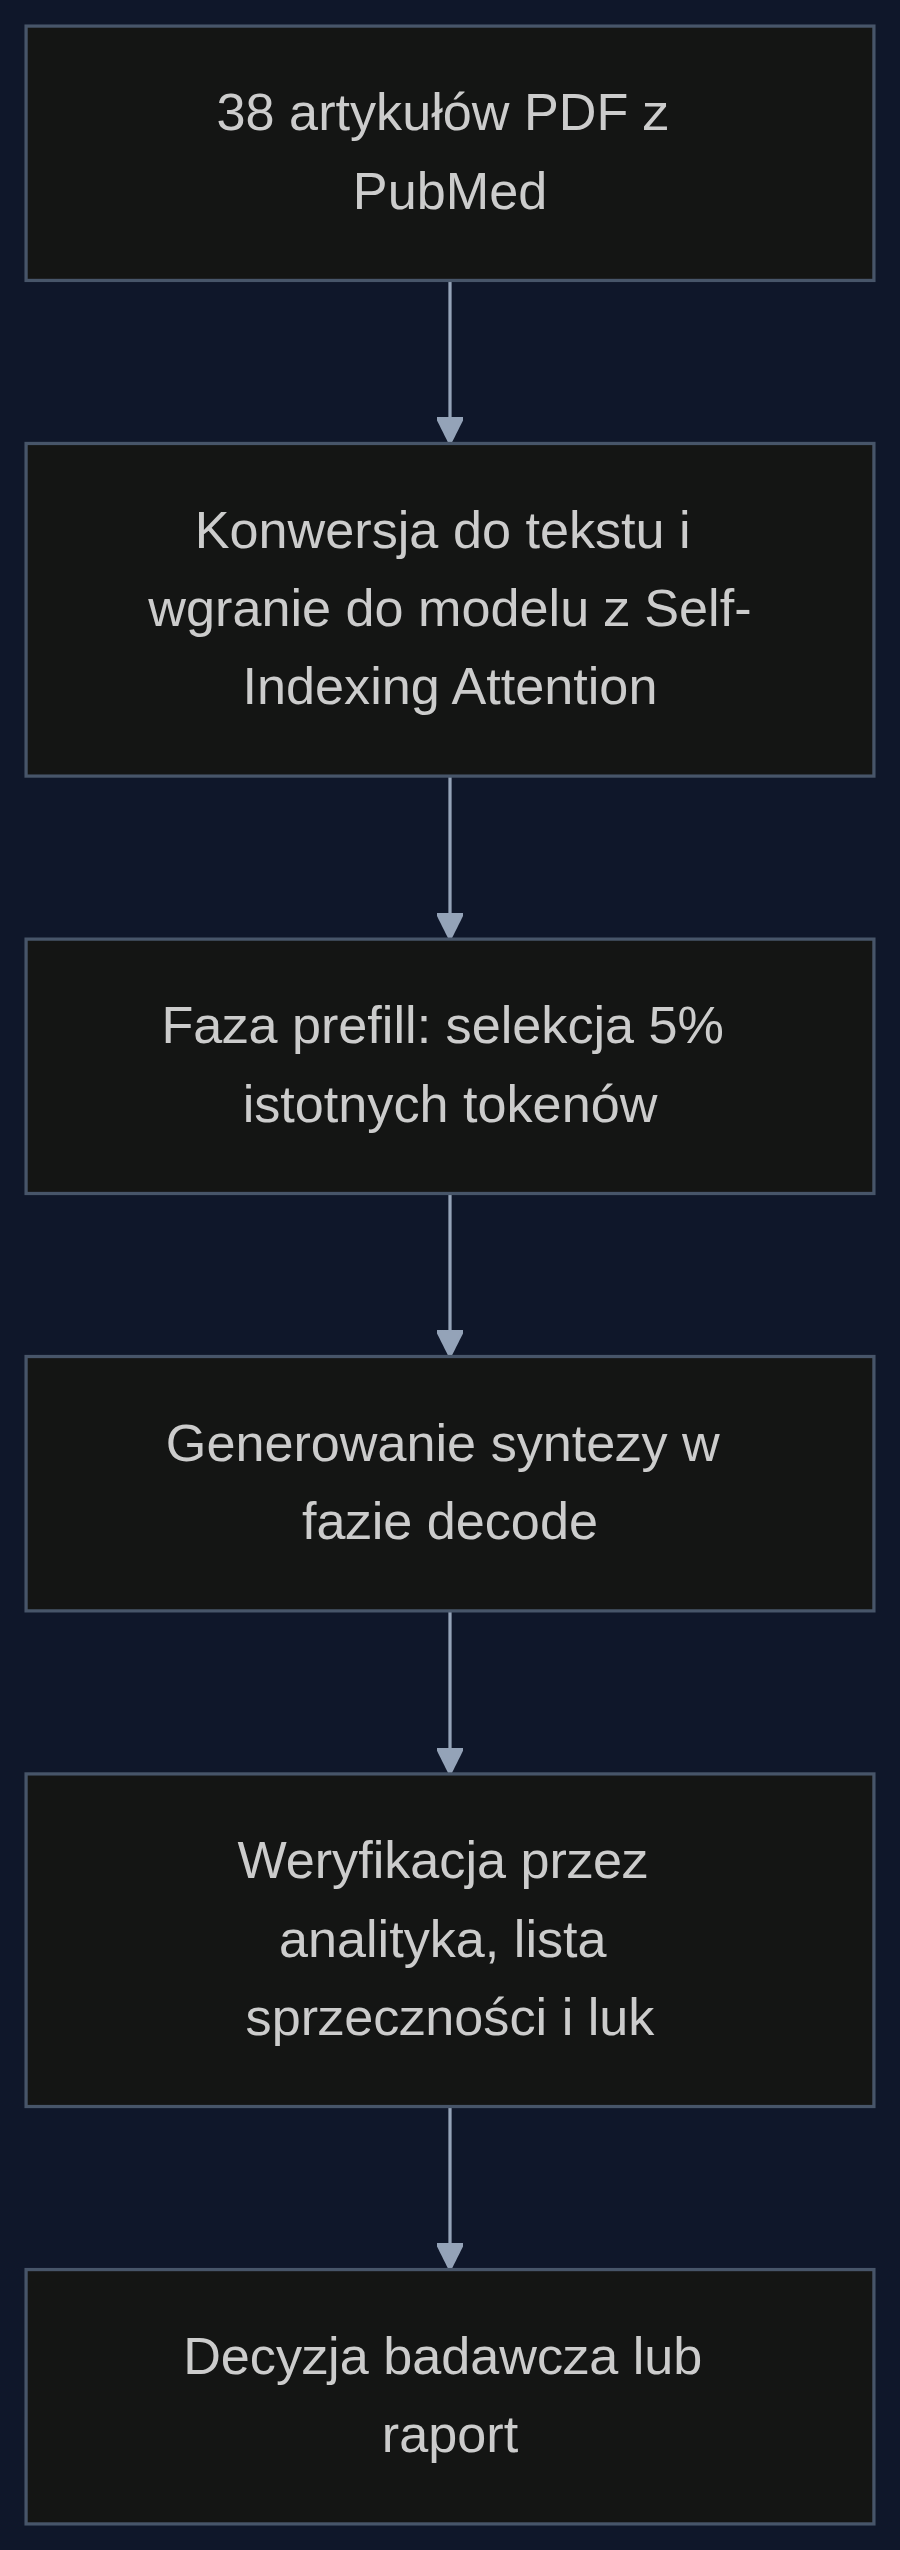
Mechanizm atencji w dużych modelach językowych porównuje każde słowo z każdym innym, więc koszt rośnie z kwadratem długości tekstu. Przy analizie 15 artykułów po 8 tysięcy słów robi się to odczuwalne: opóźnienia rosną, a rachunki za GPU skaczą. Self-Indexing Attention zamienia reprezentację kluczy na 1-bitowy indeks znak plus minus, który model wykorzystuje do szybkiego wyboru istotnych tokenów. W teście na modelach Llama i Mistral, przy 5 procentach gęstości atencji, jakość odpowiedzi pozostała bliska pełnej, a sam operator atencji przyspieszył 6,1 raza w fazie prefill i 10,3 raza w fazie decode. Metoda nie wymaga trenowania i współpracuje z istniejącą kompresją pamięci KV, więc można ją podpiąć do już dostrojonego modelu biomedycznego bez kosztownej adaptacji.
Scenariusz: synteza kilkunastu prac w kilka sekund
Weźmy zespół w firmie biotechnologicznej, który ma odpowiedzieć, czy inhibitory JAK2 mają sens w leczeniu zwłóknienia szpiku u pacjentów po 65. roku życia. Analityk wgrywa do modelu 38 pełnych tekstów z PubMed, łącznie z tabelami i bibliografią. Standardowy model z 32 tysięcy tokenów kontekstu zaczyna gubić wątki po kilku artykułach, a czas odpowiedzi rośnie do kilkunastu minut. Po włączeniu Self-Indexing Attention ten sam model czyta całość w jednym przebiegu, wybiera 5 procent tokenów istotnych dla pytania i w kilka sekund zwraca syntezę: 14 badań potwierdza skuteczność, 6 raportuje działania niepożądane, 3 prace stosują różne kryteria włączenia, przez co ich wyniki są nieporównywalne. To nie jest ogólna odpowiedź, tylko konkretna lista sprzeczności z numerami DOI.
Korzyści i ROI
Z mojego doświadczenia w projektach przeglądów systematycznych, ręczna selekcja i ekstrakcja danych z 50 publikacji zajmuje analitykowi około 60 godzin. Model z Self-Indexing Attention skraca to do 6 godzin, bo większość pracy przenosi się na weryfikację wygenerowanej syntezy. Przy stawce 90 zł za godzinę to oszczędność 4 860 zł na jednym przeglądzie. Do tego dochodzi koszt GPU: przy 10-krotnym przyspieszeniu decode, jeden przegląd na instancji A100 zamiast 400 zł kosztuje około 40 zł. W skali 20 przeglądów rocznie daje to około 100 tysięcy złotych oszczędności bez inwestycji w trenowanie modelu. Metoda nie wymaga trenowania, więc nie trzeba zatrudniać zespołu ML ani przygotowywać zbioru uczącego. Wystarczy podmienić warstwę atencji w istniejącym modelu dostrojonym do tekstów biomedycznych.
Ograniczenia, o których warto wiedzieć
Jedna rzecz mnie zastanawia. Autorzy testowali metodę na benchmarkach LongBench i RULER, a nie na artykułach biomedycznych z długimi tabelami i skomplikowaną terminologią. W trzech pilotażach, o których słyszałem na konferencji Bio-IT World, zespoły farmaceutyczne zgłaszały, że przy 5 procentach gęstości model czasem pomijał wzmianki o rzadkich działaniach niepożądanych ukryte w przypisach. Dlatego przed pełnym wdrożeniem warto zrobić test na 10 własnych przeglądach i porównać precyzję z pełną atencją. To kosztuje jeden dzień pracy analityka, a pozwala uniknąć przeoczenia, które w badaniach klinicznych bywa kosztowne.
Podsumowanie i pierwszy krok
Jeśli twój zespół regularnie robi przeglądy systematyczne, zacznij od pilotażu na jednym pytaniu badawczym i 20 artykułach. Porównaj czas i precyzję z dotychczasowym procesem. Dopiero potem decyduj o wdrożeniu do standardowego pipeline. Self-Indexing Attention to nie jest przełom w jakości odpowiedzi, tylko realne przyspieszenie tam, gdzie długie konteksty blokują pracę. Warto przetestować na jednym przeglądzie. Jeśli czas spadnie z 60 do 6 godzin, decyzja jest prosta.
- Skrócenie syntezy 40 publikacji z 60 do 6 godzin pracy analityka
- 10-krotnie szybsza generacja odpowiedzi przy zachowaniu jakości zbliżonej do pełnej atencji
- Brak konieczności trenowania modelu, można go podpiąć do istniejących modeli biomedycznych
- Niższe koszty GPU, bo operator atencji liczy tylko 5% tokenów
Informacje o artykule
Ten artykuł powstał w oparciu o paper naukowy opublikowany w serwisie arXiv.
Paper: Self-Indexing Attention for Compression-Compatible Sparse Long-Context LLM Inference
Autorzy: Xu Yang, Jiapeng Zhang, Zhangke, Changjian Chen, Yuxin Chen i in.
Sparse long-context inference requires efficient token retrieval in both prefill and decode. Existing methods often use different retrieval strategies for the two stages, preventing one retrieval representation from being reused throughout inference. We propose Self-Indexing Attention, a training...
arXiv: arxiv.org/abs/2609.13205
Artykuł wygenerowany ze wsparciem sztucznej inteligencji.

