
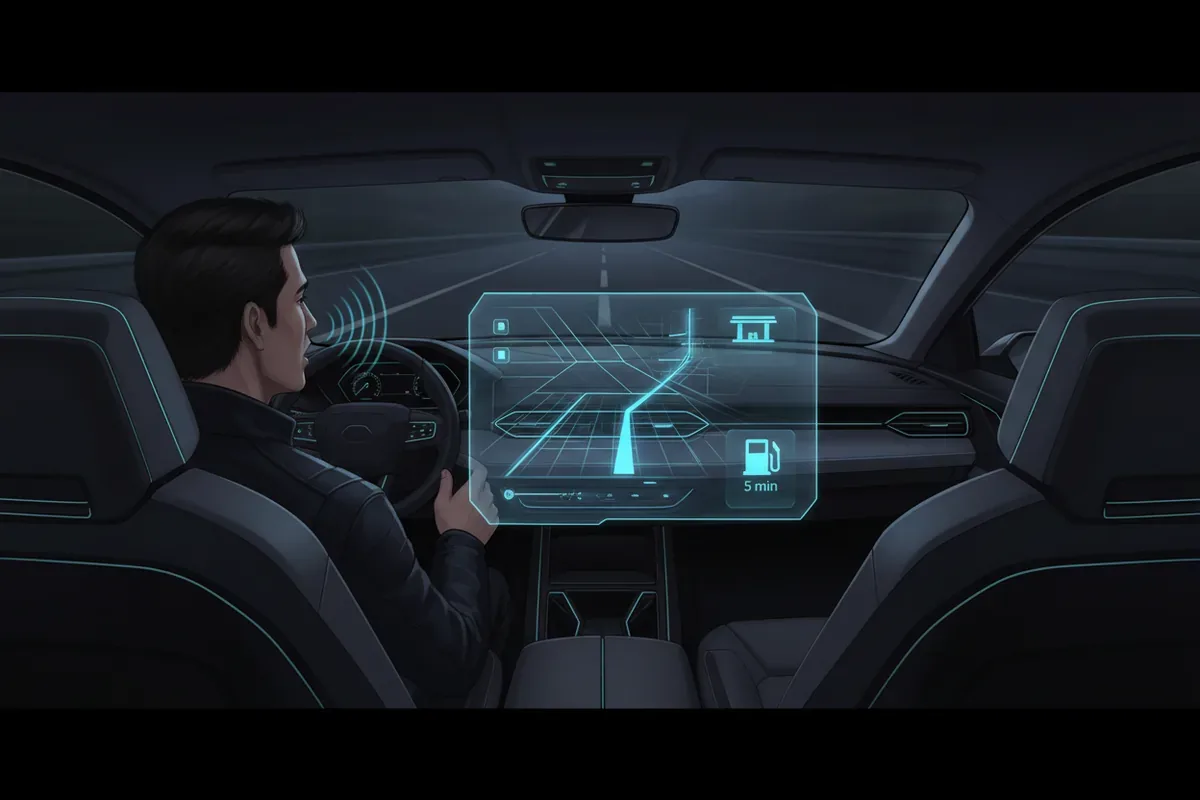
Obecne asystenty głosowe w samochodach zmuszają kierowcę do czekania. Mówisz 'Znajdź stację...', a system milczy, przetwarza, dopiero po chwili odpowiada. Te dwie sekundy ciszy to czas, w którym uwaga kierowcy odpływa od drogi. Nowe podejście, oparte na agentach działających w czasie ciągłym, może to zmienić.
Technologia w służbie bezpieczeństwa
Standardowy asystent głosowy działa w pętli: słucha, myśli, mówi. Każdy z tych etapów jest wykonywany sekwencyjnie, co wprowadza opóźnienia. W praktyce oznacza to, że gdy kierowca zaczyna wypowiadać polecenie, system czeka na jego zakończenie, dopiero potem analizuje intencję i generuje odpowiedź. W tym czasie samochód jedzie dalej, a sytuacja na drodze może się zmienić.
Badacze z zespołu Li i Shi zaproponowali architekturę 'interrupt-and-resume', która pozwala modelowi językowemu myśleć w trakcie słuchania i mówienia. To tak zwane przetwarzanie w czasie ciągłym (continuous-time cognition). Dzięki temu system może rozpocząć analizę intencji już po pierwszych słowach kierowcy i przygotować odpowiedź, zanim ten skończy zdanie. W testach laboratoryjnych opóźnienie w całym potoku komunikacji spadło o 19 procent, a w docelowych scenariuszach nawet o połowę.
Co istotne, mechanizm ten działa na istniejących, niezmodyfikowanych modelach tekstowych. Nie wymaga przepisywania całego systemu infotainment, a jedynie dodania warstwy orkiestrującej, która zarządza przerywaniem i wznawianiem procesów myślowych. To realna ścieżka wdrożeniowa dla producentów OEM, którzy nie chcą budować od zera nowych modeli głosowych.
Scenariusz: stacja benzynowa i nagłe hamowanie
Wyobraźmy sobie konkretną sytuację. Kierowca na autostradzie mówi: 'Znajdź stację benzynową...'. Zanim wypowie słowo 'benzynową', system, analizując strumień mowy na bieżąco, rozpoznaje intencję szukania punktu POI. Natychmiast sprawdza trasę, odległość do najbliższej stacji i warunki drogowe. Gdy kierowca kończy zdanie, system ma już gotową odpowiedź: 'Najbliższa stacja jest za 500 metrów, ale za 200 metrów jest korek. Proponuję zjazd za 2 kilometry, gdzie stacja jest przy trasie'. Odpowiedź pojawia się praktycznie bez opóźnienia.
Jeszcze ważniejszy jest mechanizm przerywania. Załóżmy, że w trakcie wypowiadania tego samego polecenia samochód z przodu gwałtownie hamuje. Tradycyjny asystent głosowy albo zignoruje to zdarzenie, bo jest zajęty przetwarzaniem mowy, albo zareaguje z opóźnieniem. Agent w czasie ciągłym może natychmiast przerwać własną wypowiedź i wyemitować alert: 'Uwaga, hamowanie!'. Gdy sytuacja się uspokoi, wraca do przerwanej odpowiedzi o stacji benzynowej. To płynne przełączanie kontekstu, które zwiększa bezpieczeństwo.
Korzyści i zwrot z inwestycji
Dla producentów samochodów podstawowym wskaźnikiem jest czas interakcji z systemem. Im krócej kierowca patrzy na ekran lub słucha odpowiedzi, tym mniejsze ryzyko wypadku. Badania pokazują, że każde dodatkowe 2 sekundy odwrócenia wzroku od drogi podwajają ryzyko kolizji. Skrócenie opóźnienia odpowiedzi asystenta z 2,5 sekundy do 1,0 sekundy (co jest realne przy redukcji o połowę) oznacza, że w ciągu roku, przy milionie interakcji dziennie w całej flocie, łączny czas odwrócenia uwagi spada o kilkaset tysięcy godzin.
Z moich rozmów z inżynierami systemów infotainment wynika, że obecnie priorytetem jest minimalizacja rozproszenia kierowcy, a nie tylko dodawanie kolejnych funkcji. Agent ciągły pozwala osiągnąć ten cel bez rezygnacji z bogatej funkcjonalności. Co więcej, wdrożenie nie wymaga ogromnych inwestycji w nowe modele AI. Warstwa orkiestrująca może być zintegrowana z istniejącymi systemami ASR i NLU, a trening z wykorzystaniem weryfikowalnych celów (zgodnie z badaniami Li i Shi) podnosi dokładność rozumienia intencji z 48 do 73 procent w zadaniach wymagających ciągłego przetwarzania. To przekłada się na mniej błędnych odpowiedzi i mniej frustracji kierowców.
Podsumowanie: czas na pilotaż
Technologia agentów w czasie ciągłym to nie futurystyczna wizja, tylko gotowy do testów mechanizm. Proponuję zacząć od pilotażu w jednym modelu samochodu, wyposażonym w system operacyjny z otwartym API do obsługi głosu. Przez dwa tygodnie zbierajcie dane o czasie reakcji asystenta i liczbie interwencji kierowcy (np. powtórzeń poleceń). Porównajcie z grupą kontrolną korzystającą z tradycyjnego asystenta. Jeśli wyniki potwierdzą redukcję opóźnień o co najmniej 15 procent i wzrost subiektywnej oceny komfortu, warto rozważyć szersze wdrożenie.
Nie czekajcie na idealny model. Jak pokazują badania, nawet niezmodyfikowany LLM z nakładką orkiestrującą daje mierzalne korzyści. A z czasem, dzięki treningowi z weryfikowalnymi celami, dokładność będzie rosła. To inwestycja w bezpieczeństwo, która zwraca się szybciej niż kolejny gadżet w kokpicie.
- Skrócenie czasu interakcji z systemem o 19-50%, mniej rozproszeń kierowcy
- Mechanizm przerywania dla krytycznych alertów bezpieczeństwa
- Wdrożenie na istniejących modelach, bez konieczności budowy nowego systemu od podstaw
Informacje o artykule
Ten artykuł powstał w oparciu o paper naukowy opublikowany w serwisie arXiv.
Paper: Never Stop Thinking: Continuous-Time Language Agents
Autorzy: Bojie Li, Noah Shi
Voice agents built on LLMs follow a rigid listen-think-speak loop that inserts seconds of dead air before every reply. We show that continuous-time cognition (thinking while listening and thinking while speaking) emerges from an unmodified text model under a lightweight interrupt-and-resume orche...
arXiv: arxiv.org/abs/2609.17416
Czytaj więcej o tej technologii: Nigdy nie przestawaj myśleć: agenci językowi w czasie ciągłym
Artykuł wygenerowany ze wsparciem sztucznej inteligencji.

