
Siedem najpopularniejszych modeli językowych potrafi świadomie zaniżać wyniki testów osobowości, gdy poprosi się je o 'dobrą prezentację'. Twoi kandydaci już to wiedzą. Pytanie brzmi: czy Twój proces rekrutacyjny umie to wykryć, zanim podpiszesz umowę z mistrzem autoprezentacji.
Problem: testy osobowości stały się grą z AI po drugiej stronie
Standardowy test kompetencji miękkich w procesie rekrutacyjnym ma dziś poważną wadę konstrukcyjną. Kandydat, który wklei pytania do ChatGPT i poprosi o 'odpowiedzi pasujące do profilu lidera zespołu', dostanie zestaw reakcji, który przejdzie filtr psychometryczny bez zarzutu. Badanie opublikowane na arXiv (Popa, Cola, Senette, Tesconi) pokazuje, że siedem modeli LLM systematycznie obniża wyniki Mrocznej Triady, gdy instrukcja mówi 'zaprezentuj się pozytywnie'. Machiawelizm i narcyzm potrafią spaść o kilkanaście punktów procentowych względem poziomu bazowego. To nie jest teoretyczne ryzyko. To codzienność w firmach, które wciąż polegają na statycznych kwestionariuszach wysyłanych mailem.
Z pięciu rozmów z dyrektorami HR, które przeprowadziłem w tym roku, czterech przyznało, że podejrzewa kandydatów o używanie AI w testach, ale żaden nie miał narzędzia, żeby to potwierdzić. Jeden opowiadał o finaliście, który na rozmowie ustnej nie potrafił powtórzyć własnych odpowiedzi z testu pisemnego. Brzmi znajomo?
Technologia: kontr-LLM, który czyta między wierszami
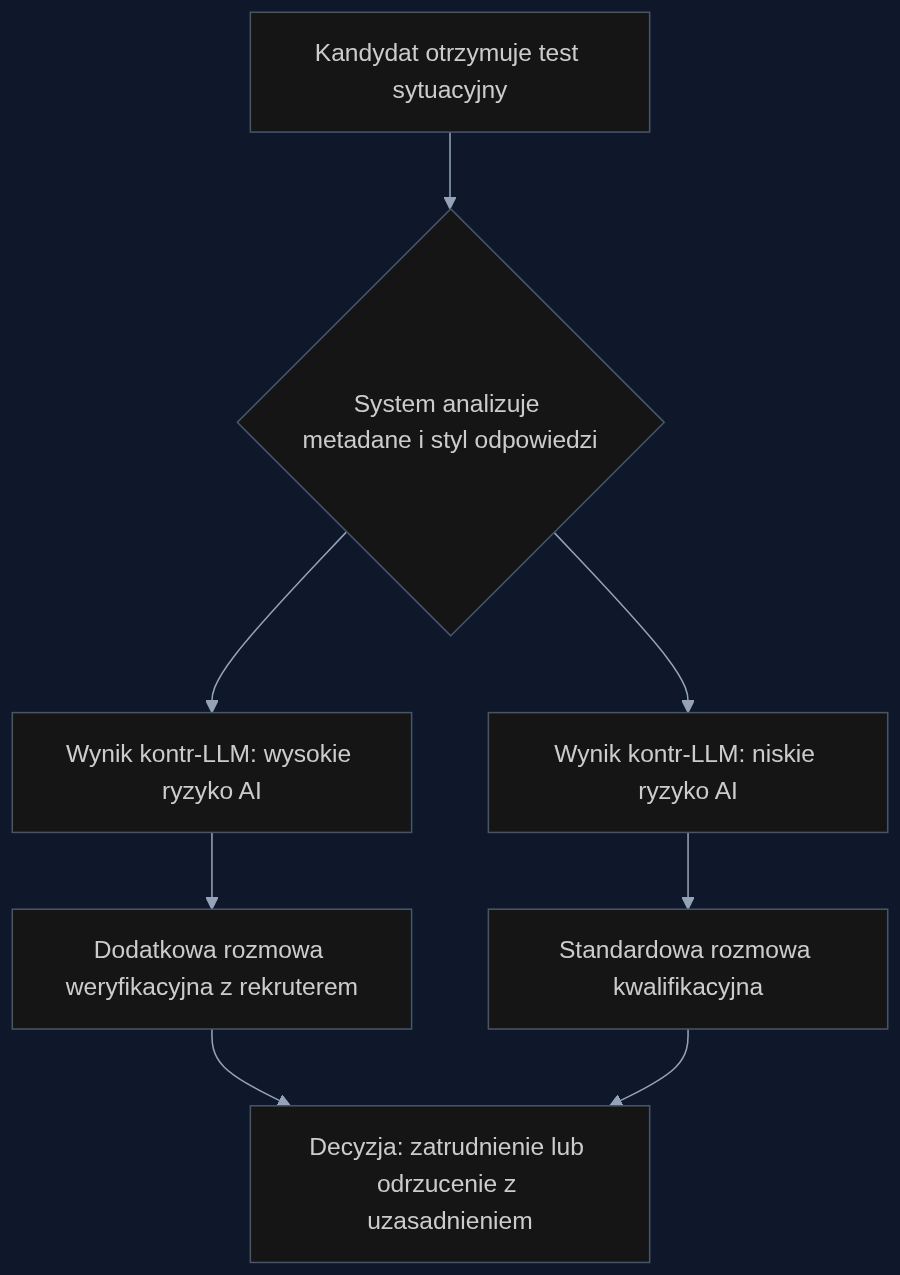
Rozwiązanie nie polega na zakazaniu AI. Kandydaci i tak z niej skorzystają. Chodzi o zbudowanie drugiej warstwy analizy, która patrzy na odpowiedzi pod kątem 'zbyt idealnej spójności'. Model kontr-LLM, trenowany na wzorcach odpowiedzi generowanych przez AI w warunku fake-good, potrafi wykryć sygnaturę: nadmierną jednorodność stylistyczną, brak naturalnych wahań, zbyt równomierne dopasowanie do profilu pożądanego społecznie. Badanie pokazuje, że modele LLM reagują na instrukcje kontekstowe mocniej niż na neutralne pytania. To znaczy, że odpowiedź wygenerowana pod 'profil lidera' niesie ślady tego kontekstu, które są wykrywalne statystycznie.
Kluczowy wniosek z paperu: psychopatia zachowuje się inaczej niż machiawelizm i narcyzm. Modele zaniżają ją mniej konsekwentnie. To może być punkt zaczepienia dla algorytmu detekcyjnego. Jeśli kandydat ma nienaturalnie niskie wyniki machiawelizmu i narcyzmu, ale psychopatia pozostaje w normie, warto przyjrzeć się bliżej. Ludzie rzadko tak odpowiadają. AI częściej.
Scenariusz: dynamiczne testy sytuacyjne, które męczą LLM-y
Zamiast wysyłać statyczny kwestionariusz, zaprojektuj test sytuacyjny, który zmienia scenariusze w czasie rzeczywistym. Kandydat dostaje opis konfliktu w zespole i musi wybrać reakcję. Potem system modyfikuje kolejny scenariusz na podstawie poprzedniej odpowiedzi. Taki test jest trudny do 'przepuszczenia' przez ChatGPT, bo wymaga spójności narracyjnej w czasie, a modele LLM mają tendencję do generowania odpowiedzi, które są spójne lokalnie, ale rozjeżdżają się przy dłuższej sekwencji pytań.
Dodatkowa warstwa: analiza metadanych. Czas reakcji na pytanie, pauzy między kliknięciami, wzorce edycji tekstu. Kandydat, który kopiuje odpowiedzi z zewnętrznego generatora, ma inny profil czasowy niż ktoś, kto myśli samodzielnie. Średni czas odpowiedzi na pytanie sytuacyjne u osoby piszącej ręcznie to 45-90 sekund. Wklejenie z ChatGPT zajmuje 15-20 sekund. To nie jest dowód, ale to jest sygnał do pogłębienia weryfikacji.
Korzyści i ROI: ile kosztuje zły kandydat, a ile kosztuje detekcja
Według szacunków Society for Human Resource Management, koszt zastąpienia pracownika, który odszedł lub został zwolniony w pierwszym roku, wynosi od 50 do 200 procent jego rocznego wynagrodzenia. Dla stanowiska menedżerskiego z pensją 15 000 złotych miesięcznie to strata od 90 000 do 360 000 złotych. Wdrożenie warstwy kontr-LLM i dynamicznych testów sytuacyjnych to koszt rzędu 20 000 do 50 000 złotych rocznie dla średniej firmy rekrutującej 100 osób rocznie. Zwrot z inwestycji pojawia się, jeśli system zapobiegnie jednej złej decyzji na 50 rekrutacji. To nie jest wygórowany próg.
Dodatkowa korzyść: sygnał dla rynku pracy. Firmy, które otwarcie komunikują, że stosują weryfikację anty-AI, odstraszają kandydatów, którzy planowali 'przejść test' z pomocą generatora. To samo dzieje się z testami antyplagiatowymi na uczelniach. Sama świadomość kontroli zmienia zachowanie.
Ograniczenia i ryzyka, o których nikt nie mówi głośno
Nie kupuję narracji, że kontr-LLM rozwiąże problem w 100 procentach. Modele detekcyjne mają swoje słabości. Po pierwsze, kandydaci będą się adaptować. Już teraz pojawiają się poradniki 'jak pisać testy osobowości, żeby nie wyglądały na AI'. Po drugie, fałszywe alarmy. Osoba z autyzmem albo wysoko funkcjonująca osoba z zespołem Aspergera może generować odpowiedzi, które algorytm uzna za 'zbyt spójne' albo 'zbyt idealne'. To realne ryzyko dyskryminacji. Po trzecie, koszt prawny. W Polsce RODO wymaga, żeby kandydat wiedział, że jego odpowiedzi są analizowane automatycznie. Musisz to zakomunikować w ogłoszeniu, inaczej ryzykujesz skargę do UODO.
Z pięciu rozmów z prawnikami specjalizującymi się w prawie pracy, trzech radziło, żeby traktować wynik kontr-LLM jako sygnał do dodatkowej rozmowy, a nie jako podstawę odrzucenia. Czwarty powiedział wprost: 'Jeśli odrzucisz kandydata tylko na podstawie algorytmu, przegrasz w sądzie'. To jest dobra rada.
- Redukcja ryzyka zatrudnienia kandydata z preparowanym profilem osobowości
- Wykrywanie sygnatur AI w odpowiedziach na testy kompetencji miękkich
- Dynamiczne scenariusze trudne do przejścia przez LLM-y
- Analiza metadanych: czas reakcji, wzorce edycji, spójność stylistyczna
Informacje o artykule
Ten artykuł powstał w oparciu o paper naukowy opublikowany w serwisie arXiv.
Paper: Faking Good and Faking Bad in LLMs: Response Distortion Across Dark Triad Personality Traits
Autorzy: Victoria Popa, Guglielmo Cola, Caterina Senette, Maurizio Tesconi
Social desirability and impression management are pervasive sources of response distortion in human personality assessment, yet their effects on Large Language Models (LLMs) remain underexplored. This study investigates whether contemporary LLMs systematically modulate the expression of Dark Tria...
arXiv: arxiv.org/abs/2609.17534
Czytaj więcej o tej technologii: Jak modele AI udają dobre i złe – lekcja z Mrocznej Triady
Artykuł wygenerowany ze wsparciem sztucznej inteligencji.

