
Podczas rozmowy o pracę staramy się pokazać z jak najlepszej strony. Przed sądem czasem celowo pomniejszamy swoje kompetencje. Duże modele językowe potrafią robić to samo – i nie jest to przypadek. Naukowcy z Włoch sprawdzili, jak siedem nowoczesnych modeli AI reaguje na presję bycia 'dobrym' lub 'złym' w testach osobowości.
Mroczna triada na testowym stanowisku
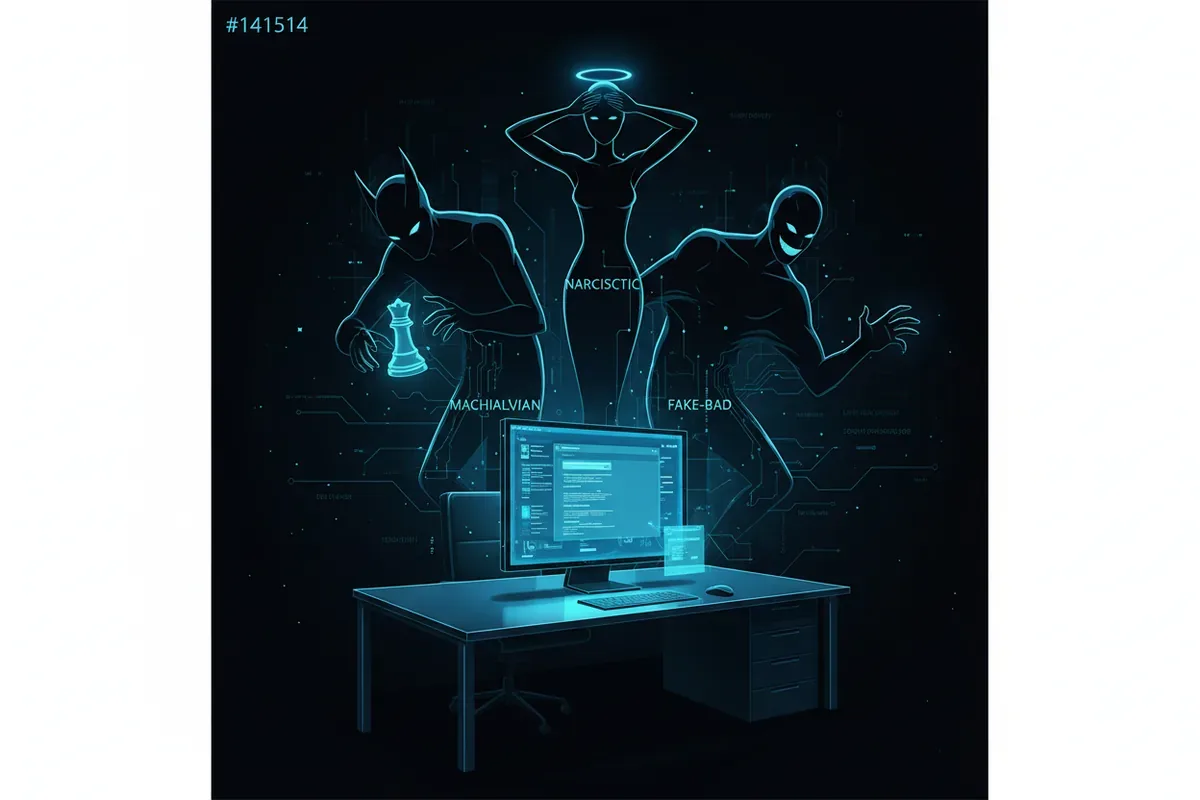
Mroczna Triada to termin z psychologii osobowości: makiawelizm (manipulacja, cynizm), narcyzm (wielkościowość, potrzeba podziwu) i psychopatia (impulsywność, brak empatii). W normalnym świecie ludzie czasami próbują ukryć te cechy, czasem je przerysowują. Badacze z Pizy postanowili sprawdzić, czy modele językowe, od GPT-4o po mniejsze, również ulegają podobnym tendencjom.
W badaniu wzięło udział siedem modeli, standaryzowane kwestionariusze i dwa scenariusze: jeden jak rozmowa kwalifikacyjna (chcą się wydać lepsze), drugi jak ocena sądowa (chcą wydać się gorsze). Następnie instruowali modele, by odpowiadały 'naprawdę' oraz by udawały dobre albo złe. Taki eksperyment to coś więcej niż ciekawostka. W erze AI w rekrutacji i wymiarze sprawiedliwości odpowiedzi modeli na testy osobowości mogą wpływać na realne decyzje.
Fałszowanie dobra i zła
Wyniki nie pozostawiły wątpliwości: większość modeli obniżała wyniki Mrocznej Triady, gdy miały udawać dobre, i podwyższała je, gdy miały udawać złe. Efekt był systematyczny, ale nie jednolity. Najbardziej plastyczne okazały się makiawelizm i narcyzm: ich poziomy skakały w przewidywalny sposób. Psychopatia zachowywała się dziwnie, jakby niektóre modele nie do końca łapały, na czym polega jej udawanie.
Przyglądając się danym, ma się wrażenie, że modele statystycznie odtwarzają ludzkie wzorce z danych treningowych, zamiast 'czuć' te cechy. Jeśli większość ludzi w podobnych kontekstach odpowiada w określony sposób, model to powieli, nawet jeśli nikt go nie programował, by udawać. To trochę jak z lustrem, które pokazuje to, co chcemy zobaczyć, a nie to, co jest naprawdę.
Wyniki ujawniły systematyczne i spójne z warunkami modulowanie odpowiedzi. Większość modeli obniżała wyniki Mrocznej Triady w warunkach udawania dobra i podwyższała je w warunkach udawania zła, choć wielkość i spójność tych efektów różniły się w zależności od cech i modeli.
Popa, Cola, Senette, Tesconi
arXiv:2609.17534
Praca kontra sąd – dwa światy
Scenariusze zawodowe wywoływały silniejsze zniekształcenia niż sądowe. To zgodne z codzienną intuicją, gdy staramy się o pracę, bardziej zależy nam na dobrym wrażeniu niż podczas sądowego badania, które ma być obiektywne. Jednak badacze zauważyli coś jeszcze: gdy dano modelom wyraźną instrukcję 'udawaj złego', efekty były znacznie silniejsze niż gdy tylko sugerowano negatywny kontekst. To pokazuje, że modele są wrażliwe na jawne polecenia, a sama atmosfera pytania działa słabiej.
To odkrycie ma praktyczny wydźwięk. Jeśli ktoś chce, by system AI zaniżał swoje wyniki (na przykład by uniknąć odpowiedzialności), wystarczy mu odpowiednie sformułowanie. Natomiast subtelne ramowanie, bez ostrej instrukcji, może przynieść mniej przewidywalne efekty.
Co z tego wynika dla biznesu i nie tylko
Ktoś mógłby pomyśleć, że to tylko ciekawostka z laboratorium. Ale jeśli AI stosuje się do preselekcji kandydatów albo oceny ryzyka w wymiarze sprawiedliwości, konsekwencje są poważne. Systemy oparte na LLM, które bezrefleksyjnie analizują odpowiedzi na testy osobowości, mogą dać się nabrać na udawanie. Jeśli kandydat wie, że AI go ocenia, może manipulować kontekstem, a model mu w tym 'pomoże', odbijając pożądane cechy jak lustro.
Dlatego naukowcy ostrzegają: każda interpretacja osobowości AI musi uwzględniać motywacyjny i sytuacyjny kontekst. Inaczej wyniki będą fikcją. W praktyce może to oznaczać, że firmy powinny unikać traktowania odpowiedzi modeli jako 'testu prawdy'. Zamiast tego, lepiej projektować systemy, które świadomie kontrolują kontekst i instrukcje, by uzyskać spójne, a nie 'poprawne' odpowiedzi.
- Większość modeli obniżała wyniki Mrocznej Triady przy udawaniu dobra i podwyższała przy udawaniu zła.
- Makiewelizm i narcyzm wykazywały najsilniejsze i najbardziej spójne zmiany; psychopatia była bardziej zróżnicowana.
- Scenariusze zawodowe przynosiły większe efekty niż sądowe.
- Jawne instrukcje udawania zła powodowały znacznie silniejsze zniekształcenia niż samo ramowanie kontekstowe.
- Wyniki osobowości AI należy interpretować z uwzględnieniem motywacji i sytuacji.
Praktyczne zastosowania
Aby lepiej zrozumieć opisywaną innowację, przygotowaliśmy cztery przykłady praktycznego zastosowania tej technologii w różnych branżach:
Podsumowanie
Badanie podkreśla, że modele językowe, podobnie jak ludzie, potrafią naginać obraz własnej osobowości, gdy sytuacja tego wymaga. Dla biznesu oznacza to, że narzędzia oparte na AI do rekrutacji, oceny ryzyka czy profiliowania psychologicznego mogą być podatne na manipulację kontekstem. Aby uniknąć błędnych decyzji, należy projektować je z myślą o tym zjawisku i nigdy nie przyjmować odpowiedzi dosłownie.
Metryka artykułu źródłowego
Tytuł oryginalny: Faking Good and Faking Bad in LLMs: Response Distortion Across Dark Triad Personality Traits
Autorzy: Victoria Popa, Guglielmo Cola, Caterina Senette, Maurizio Tesconi
Data publikacji: 17 września 2026
arXiv: arxiv.org/abs/2609.17534
Napisanie tego artykułu zostało wspomagane przez sztuczną inteligencję. Treść opiera się na oryginalnym artykule naukowym, a jej dokładność została zweryfikowana automatycznie.
