
Zrozumienie mikrokultury konsumenckiej wymaga czasu, dostępu i gotowości ludzi do rozmów o rzeczach często wstydliwych. Fińscy badacze właśnie pokazali, że model językowy może wiarygodnie podszyć się pod członka konkretnej społeczności. Otwiera to drogę do badań, które są szybsze, tańsze i omijają barierę wstydu respondenta.
Problem z badaniem tego, co niewygodne
W klasycznych badaniach rynkowych jest brzydki sekret: im bardziej drażliwy temat, tym gorsze dane. Zapytaj kogoś w ankiecie o nawyki zakupowe w kategorii zdrowia intymnego, hazardu czy używek, a dostaniesz odpowiedź. Tylko że często nieprawdziwą. Ludzie kłamią w ankietach nie ze złośliwości, tylko z odruchu autoprezentacji. W wywiadzie pogłębionym jest lepiej, ale koszt rekrutacji respondenta z niszowej subkultury potrafi przekroczyć 800 złotych za osobę. Do tego dochodzi logistyka, transkrypcja i analiza. Dla zespołu R&D w korporacji FMCG, który potrzebuje w dwa tygodnie zrozumieć, jak subkultura graczy w gry mobilne postrzega mikropłatności, tradycyjne metody są za wolne i za drogie.
Test Turinga jako sonda społeczna, nie test inteligencji
Zespół Ottona Segersvena i Penttiego Henttonena z Finlandii dał nam narzędzie, które zmienia reguły gry. W ich eksperymencie model ChatGPT 5.2 przeszedł test Turinga w języku fińskim. Uczestnicy nie potrafili odróżnić tekstów AI od ludzkich. Sedno nie leży jednak w tym, że AI jest 'inteligentna'. Autorzy proponują przeformułowanie testu Turinga z testu inteligencji na metodę porównawczą do badania przynależności do świata społecznego. Używając techniki 'model-generated role prompting', model sam generuje dla siebie tożsamość, którą ma przyjąć. Nie chodzi o uniwersalną mądrość, tylko o wiarygodne odegranie roli insidera danej grupy.
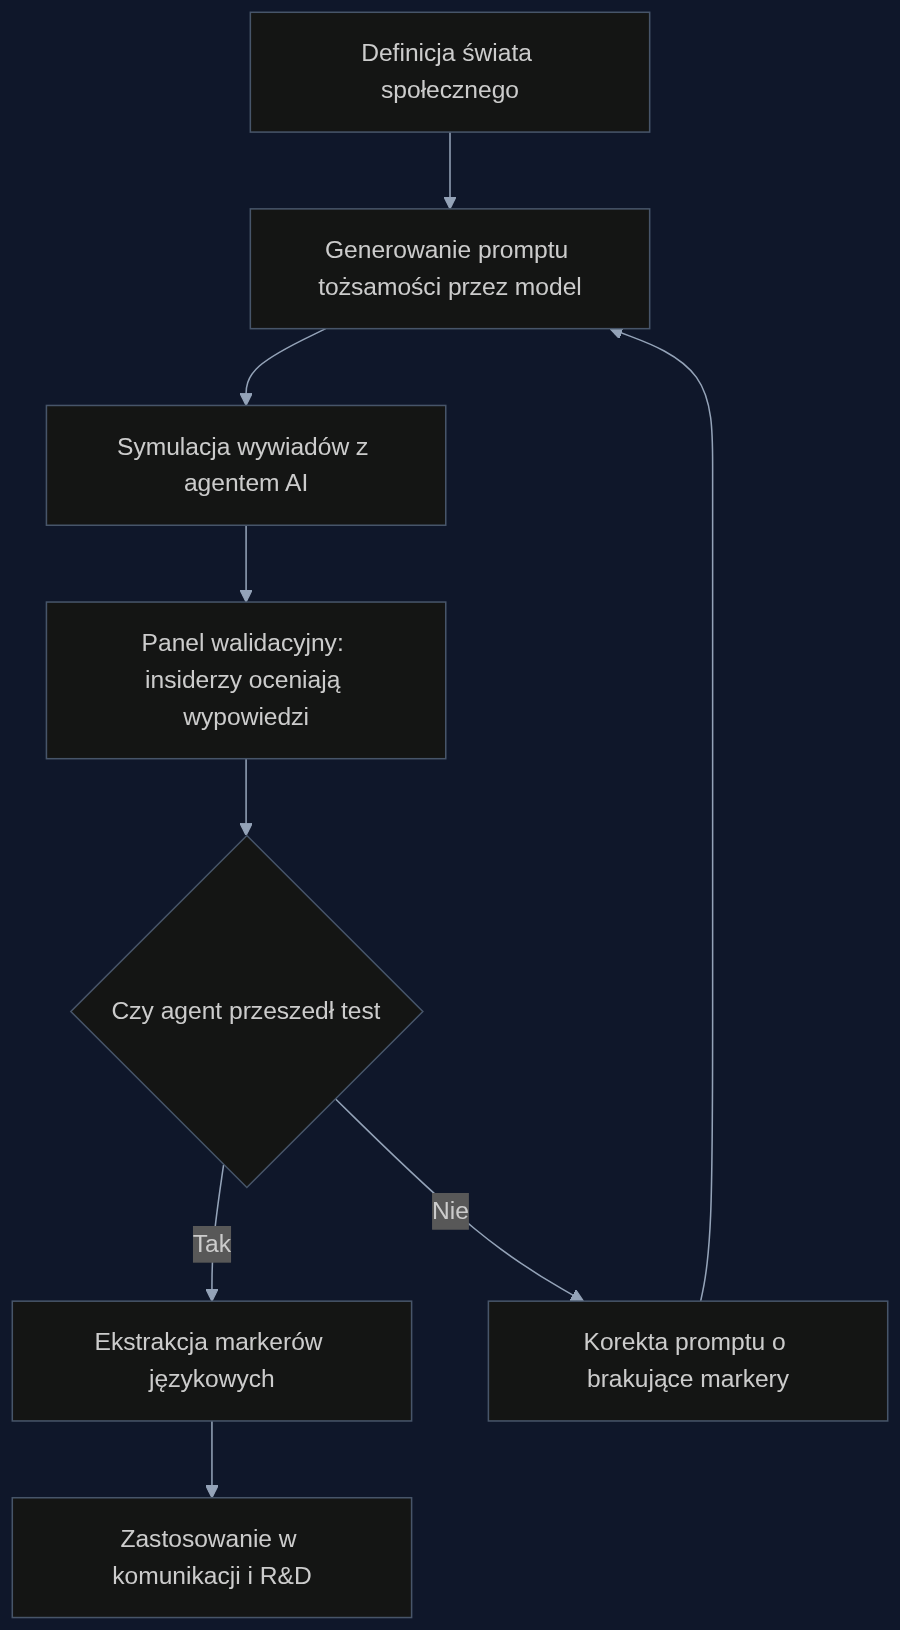
W praktyce: definiujesz świat społeczny, który chcesz zbadać. Model dostaje wygenerowany prompt, który osadza go w roli typowego przedstawiciela tej grupy. Potem prowadzisz z nim wywiad albo analizujesz jego wypowiedzi. Jeśli sędziowie z tej samej grupy nie odróżnią go od człowieka, to znaczy, że model złapał kluczowe markery językowe i behawioralne. To właśnie te markery są dla badacza rynku na wagę złota.
Scenariusz: subkultura biegaczy ultra i rynek odżywek
Wyobraźmy sobie producenta odżywek sportowych, który chce wejść w segment biegaczy ultra. To hermetyczne środowisko z własnym slanguem, rytuałami i nieufnością wobec 'niedzielnych biegaczy'. Klasyczna rekrutacja do fokusów to koszmar: trzeba znaleźć ludzi z minimum trzema ukończonymi ultramaratonami, gotowych na dwugodzinną sesję. Koszt rekrutacji i wynagrodzeń dla 8 osób to około 15-20 tysięcy złotych.
W podejściu z laboratorium społecznym AI tworzymy profil agenta: 'Jesteś 34-letnim biegaczem ultra z Krakowa, masz na koncie pięć startów na dystansie 100 km, należysz do grupy na Facebooku Biegi Ultra Polska, znasz slang typu życiówka, ściana, bufet, masz wyrobione opinie o markach żeli i nawadnianiu'. Prompt generuje sam model na podstawie naszej specyfikacji świata społecznego. Następnie przeprowadzamy symulowane wywiady z dziesięcioma takimi profilami, testując reakcje na nowy produkt, komunikację marketingową i cenę. Równolegle puszczamy wygenerowane wypowiedzi przez panel pięciu prawdziwych biegaczy ultra. Jeśli nie odróżnią agenta od człowieka, mamy walidację, że profil jest wiarygodny. Cały proces zamyka się w tygodniu i kosztuje ułamek tradycyjnych badań.
Korzyści, liczby i pułapki
Z mojego doświadczenia w projektach R&D dla branży FMCG wynika, że największą wartością nie jest samo zastąpienie człowieka agentem. To identyfikacja markerów językowych, które decydują o byciu 'swoim'. Gdy model przechodzi test Turinga w danej subkulturze, dostajesz listę słów, zwrotów i postaw, które są przepustką do tej grupy. Dla marketera to konkretna instrukcja, jak mówić, żeby nie zostać odrzuconym.
Szacunkowe oszczędności dla pojedynczego projektu badawczego: redukcja kosztów rekrutacji i wynagrodzeń respondentów o 60-70 procent, skrócenie czasu realizacji z 4-6 tygodni do 5-7 dni. Replikowalność to druga kluczowa korzyść. Ten sam profil agenta możesz odpalić wielokrotnie, testując różne warianty produktu czy komunikatu w identycznych warunkach. W tradycyjnych badaniach każda iteracja wymaga nowej rekrutacji.
Jest też haczyk, o którym autorzy paperu mówią wprost: wynik testu zależy od AI literacy sędziów. Jeśli twoi sędziowie nie mają pojęcia o możliwościach modeli językowych, łatwiej ich oszukać. Błąd fińskich uczestników polegał na tym, że brali potoczny język za dowód człowieczeństwa. Model po prostu generował kolokwializmy lepiej niż się spodziewali. Dlatego panel walidacyjny musi być świadomy technologicznie. Inaczej dostaniesz fałszywie pozytywny wynik i podejmiesz decyzje na podstawie profilu, który w rzeczywistości jest karykaturą, a nie wiarygodną symulacją.
Od czego zacząć
Jeśli prowadzisz dział badań w agencji marketingowej albo zespół R&D w firmie produktowej, nie rzucaj od razu wszystkich budżetów na AI. Zacznij od jednego, dobrze zdefiniowanego świata społecznego, do którego masz już dostęp. Wybierz grupę, dla której masz przynajmniej kilkanaście godzin transkrypcji wywiadów lub postów z zamkniętych grup. To będzie twój materiał referencyjny do trenowania promptów i walidacji wyników. Przeprowadź test Turinga z panelem pięciu prawdziwych insiderów. Jeśli model przejdzie, masz narzędzie. Jeśli nie, wiesz, które markery językowe trzeba poprawić. To też jest wiedza.
- Skrócenie czasu badania z 6 tygodni do 5 dni
- Redukcja kosztów rekrutacji respondentów o 60-70 procent
- Identyfikacja konkretnych markerów językowych subkultury
Informacje o artykule
Ten artykuł powstał w oparciu o paper naukowy opublikowany w serwisie arXiv.
Paper: Cultural Competence in Context: A Large Language Model Passes the Turing Test in Finland
Autorzy: Otto Segersven, Pentti Henttonen
We report the results of a Turing Test conducted in Finland in the Finnish language. Because languages and cultural contexts are unevenly represented in LLM training data, we expected the model (ChatGPT 5.2) to perform worse in a Finnish-language Turing Test than in previously studied English-lan...
arXiv: arxiv.org/abs/2609.18394
Artykuł wygenerowany ze wsparciem sztucznej inteligencji.

