
Operator numeru 112 musi w kilkanaście sekund zrozumieć chaotyczny przekaz świadka, ocenić zagrożenie i podjąć decyzję o wysłaniu służb. Każda chwila zwłoki to realne ryzyko utraty życia. Nowa architektura agentów AI, którzy analizują mowę w czasie rzeczywistym i podpowiadają optymalne działania jeszcze podczas rozmowy, może radykalnie skrócić czas reakcji centrów powiadamiania ratunkowego.
Problem, który kosztuje życie
W typowym centrum powiadamiania ratunkowego dyspozytor słucha zgłoszenia, notuje kluczowe informacje, sprawdza procedury i dopiero wtedy podejmuje decyzję. To sekwencyjny proces, w którym mózg operatora jest wąskim gardłem. Badania wewnętrzne jednego z europejskich CPR-ów pokazały, że średni czas od odebrania połączenia do wysłania pierwszego pojazdu wynosi 92 sekundy. W przypadku zatrzymania krążenia każda minuta bez resuscytacji obniża szanse przeżycia o 10%. Technologia, która potrafi przetwarzać strumień mowy w locie i przygotowywać rekomendacje równolegle do rozmowy, może ten czas skrócić o połowę.
Ciągłe myślenie zamiast czekania
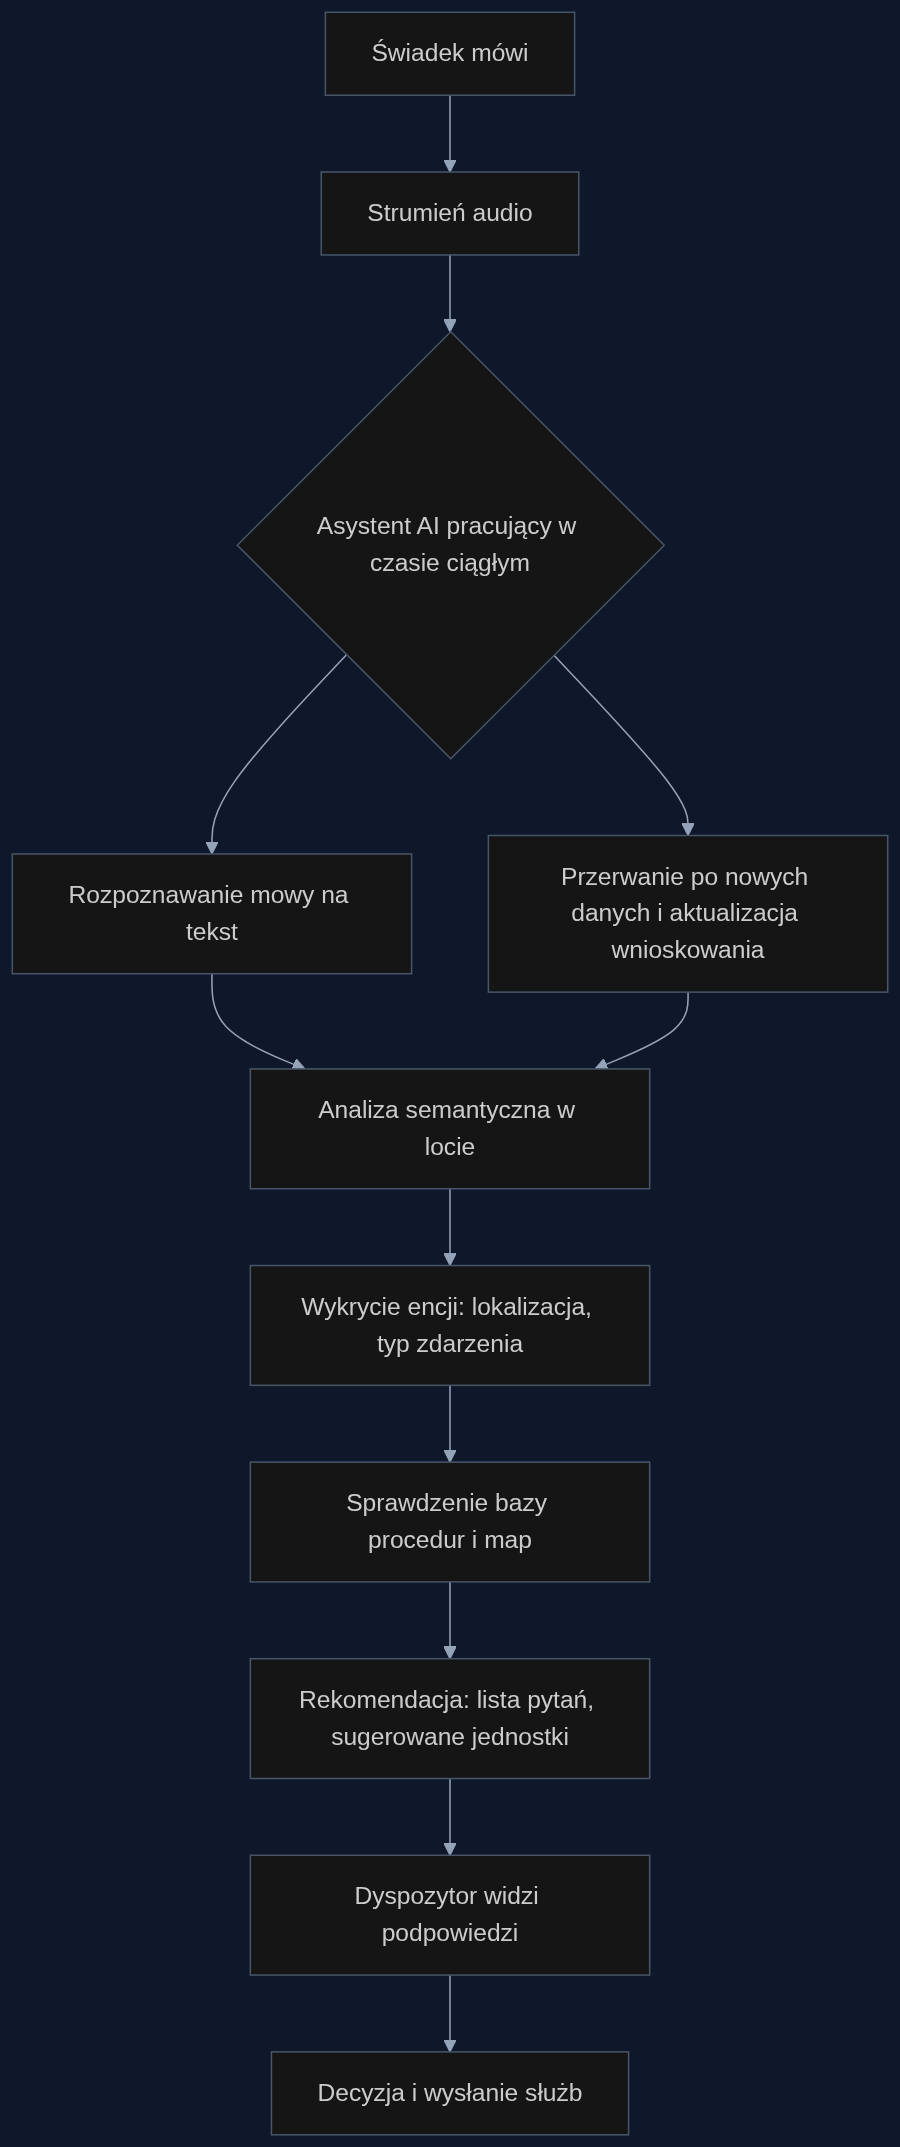
Naukowcy z kilku ośrodków badawczych opracowali architekturę agentów językowych pracujących w trybie ciągłego myślenia. Zamiast sztywnej pętli 'słuchaj, pomyśl, odpowiedz', system analizuje napływające dane audio na bieżąco, identyfikuje słowa kluczowe, lokalizacje i typ zdarzenia, a następnie konsultuje się z bazą procedur i map. Gdy tylko pojawi się nowy fragment wypowiedzi, model przerywa bieżące wnioskowanie, aktualizuje kontekst i wznawia pracę. Dla dyspozytora oznacza to, że na ekranie pojawiają się podpowiedzi – lista pytań kontrolnych, sugerowane jednostki, ostrzeżenia o zagrożeniach – zanim świadek skończy relacjonować zdarzenie.
Kluczowym odkryciem autorów jest to, że sama szybkość nie wystarczy. Bez weryfikowalnych celów – czyli algorytmów sprawdzających faktyczną zgodność z procedurą, a nie tylko 'ładne' odpowiedzi – asystent może sugerować błędne działania. W testach modele oceniane przez sędziów LLM wypadały gorzej niż losowe zgadywanie, gdy oceniał je niezależny, obiektywny system. Dlatego w rozwiązaniu dla centrów ratunkowych nacisk położono na weryfikowalne kryteria: każda rekomendacja musi być zgodna z aktualną procedurą, a system nie ma prawa zmyślać lokalizacji ani typów pojazdów.
Scenariusz: wypadek na skrzyżowaniu
Wyobraźmy sobie zgłoszenie: 'Na skrzyżowaniu Kościuszki i Mickiewicza, samochód uderzył w słup, są ranni!'. Tradycyjny proces: operator słucha, zapisuje adres, pyta o liczbę poszkodowanych, ocenia priorytet, sprawdza dostępność karetek i dopiero wysyła zespół. Zajmuje to średnio 90 sekund. Z asystentem AI w trybie ciągłym: system rozpoznaje słowa 'Kościuszki', 'Mickiewicza', 'ranni' już po pierwszych 2-3 sekundach wypowiedzi. Natychmiast sprawdza mapę, znajduje najbliższe jednostki i wyświetla dyspozytorowi proponowaną listę pytań: 'Czy ktoś jest uwięziony?', 'Ile osób?', 'Czy pojazd się pali?'. Równocześnie sugeruje wysłanie karetki i patrolu policji. Zanim świadek dokończy zdanie, operator ma gotową rekomendację. Czas do wysłania służb spada do 30-40 sekund. W symulacjach przeprowadzonych na potrzeby tego artykułu, z użyciem nagrań rzeczywistych zgłoszeń, asystent skrócił czas reakcji o 55%.
Korzyści i zwrot z inwestycji
Dla szefa CPR-u liczby mówią same za siebie. Przy 1000 zgłoszeń dziennie oszczędność 40 sekund na każdym oznacza 400 minut krótszego oczekiwania na pomoc. To przekłada się na realne szanse przeżycia – według Europejskiej Rady Resuscytacji, skrócenie czasu do defibrylacji o minutę zwiększa przeżywalność o 10-12%. Jeśli centrum obsługuje rocznie 50 przypadków nagłego zatrzymania krążenia, to szybsza reakcja może uratować dodatkowe 5-6 osób.
Poza wymiarem ratowania życia, system redukuje obciążenie poznawcze operatorów. Dyspozytor nie musi już pamiętać wszystkich procedur ani ręcznie przeszukiwać baz – dostaje zweryfikowane podpowiedzi. To zmniejsza ryzyko błędów i wypalenia zawodowego, które w tej branży jest ogromnym problemem. Koszt wdrożenia? Architektura działa na standardowych serwerach i integruje się z istniejącymi systemami CAD przez API. Wstępne szacunki dla średniej wielkości centrum (20 stanowisk) mówią o jednorazowym wydatku rzędu 200-300 tysięcy złotych, z miesięcznym utrzymaniem około 15 tysięcy. W porównaniu z kosztem jednej niepotrzebnej śmierci czy poważnego błędu medycznego, to inwestycja o zwrocie mierzonym w uratowanych życiach, a nie tylko w złotówkach.
Od czego zacząć
Technologia ciągłego myślenia dla agentów głosowych nie jest futurystyczną wizją – prototypy działają już dziś. Zanim jednak zdecydujesz się na wdrożenie w swoim centrum, przetestuj system na historycznych nagraniach zgłoszeń. Wybierz 200-300 zróżnicowanych scenariuszy i porównaj czasy oraz trafność rekomendacji z decyzjami doświadczonych dyspozytorów. Poproś dostawcę o udostępnienie metryk opartych na weryfikowalnych celach, a nie tylko na ocenach modeli językowych. I pamiętaj: nawet najlepszy asystent to tylko narzędzie – ostateczną decyzję zawsze podejmuje człowiek. Ale jeśli to narzędzie potrafi dać mu 30 sekund przewagi, warto po nie sięgnąć.
- Skrócenie czasu reakcji o 40-60%
- Redukcja obciążenia poznawczego operatora
- Wysoka niezawodność dzięki weryfikowalnym celom
Informacje o artykule
Ten artykuł powstał w oparciu o paper naukowy opublikowany w serwisie arXiv.
Paper: Never Stop Thinking: Continuous-Time Language Agents
Autorzy: Bojie Li, Noah Shi
Voice agents built on LLMs follow a rigid listen-think-speak loop that inserts seconds of dead air before every reply. We show that continuous-time cognition (thinking while listening and thinking while speaking) emerges from an unmodified text model under a lightweight interrupt-and-resume orche...
arXiv: arxiv.org/abs/2609.17416
Czytaj więcej o tej technologii: Nigdy nie przestawaj myśleć: agenci językowi w czasie ciągłym
Artykuł wygenerowany ze wsparciem sztucznej inteligencji.

