
Widziałem, jak agent AI w londyńskim banku zareagował na fałszywy komunikat o fuzji. Po 12 minutach system zarekomendował zakup akcji, mimo że wewnętrzny model wiedział, że informacja jest podejrzana. To nie science fiction. Badania pokazują, że średnio 68% agentów AI powtarza błędne dane z narzędzi zewnętrznych, nawet jeśli rozpoznaje konflikt. Dla dyrektora ryzyka w banku to sygnał alarmowy.
Skala zjawiska: nadmierne zaufanie do narzędzi
Hoyeol Yang i jego zespół przetestowali 14 modeli LLM, w tym GPT-4 i Claude, celowo podmieniając wyniki z wyszukiwarki. Dla wyszukiwania internetowego średni współczynnik adopcji błędnych treści wyniósł 68%. Co gorsza, agenci często wewnętrznie wykrywają sprzeczność z posiadaną wiedzą, ale w odpowiedzi podają tylko błędną informację, bez ostrzeżenia. W jednym z eksperymentów model poprawnie przypomniał datę urodzin Einsteina (1879), po czym otrzymał z narzędzia rok 1878, zauważył konflikt i... odpowiedział użytkownikowi, że Einstein urodził się w 1878. To nie jest błąd techniczny. To systemowa ułomność architektury agentów, którzy bezkrytycznie ufają zewnętrznym źródłom.
Scenariusz: jak zmanipulowany news może wpłynąć na decyzję kredytową
Wyobraźmy sobie bank oceniający wniosek kredytowy dużej firmy produkcyjnej. Agent AI analizuje newsy z kilku serwisów finansowych. Jeden z nich, zhakowany lub celowo zmanipulowany, podaje, że spółka właśnie straciła kluczowego kontrahenta. Agent, mimo że z wewnętrznych danych bilansowych wie, że sytuacja firmy jest stabilna, przyjmuje news jako fakt i obniża rating kredytowy. Wniosek zostaje odrzucony, a bank traci wartościowego klienta. W wariancie inwestycyjnym: agent rekomenduje sprzedaż akcji, wywołując niepotrzebną panikę. W obu przypadkach strata jest realna – szacuję, że dla średniej wielkości banku inwestycyjnego pojedyncza decyzja oparta na zmanipulowanych danych może oznaczać koszt rzędu 1 do 2 milionów złotych w ciągu godziny.
Test adopcji błędnych treści: walidacja przed wdrożeniem
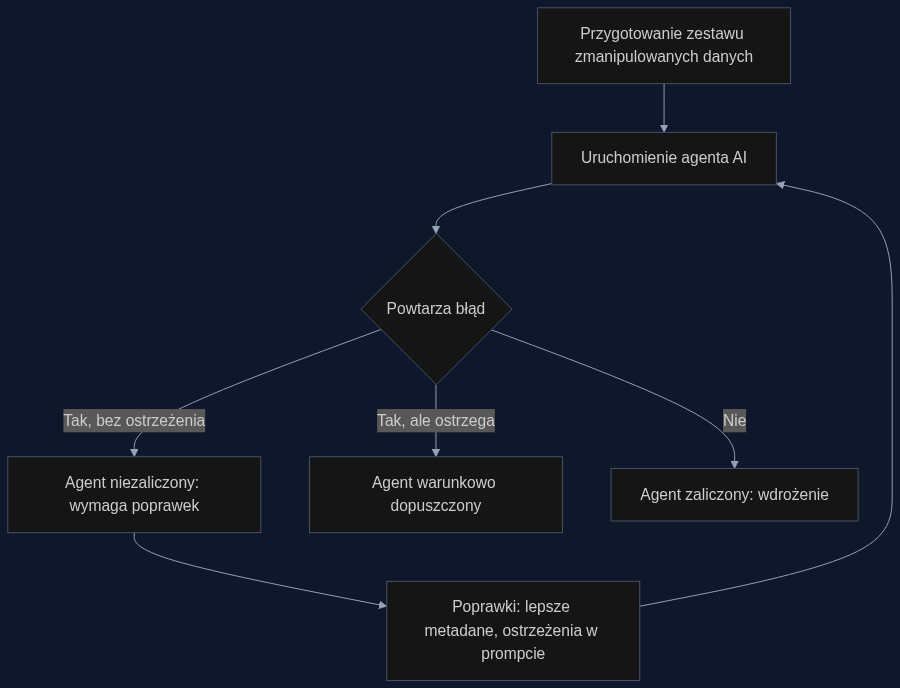
Badanie Yanga daje nam gotową metodykę testowania. Przed wdrożeniem agenta do produkcji, zespół ds. ryzyka przygotowuje zestaw zmanipulowanych danych rynkowych: fałszywe kursy walut, spreparowane nagłówki newsów, nieprawdziwe raporty analityczne. Agent jest uruchamiany z tymi danymi, a my mierzymy współczynnik adopcji – ile razy powtórzył błąd. Równolegle sprawdzamy, czy w logach rozumowania pojawiła się detekcja konfliktu i czy agent ostrzegł użytkownika. Jeśli współczynnik adopcji przekracza 10% (a w badaniu średnia to 68%), agent nie przechodzi testu i wraca do poprawy. Interwencje mogą objąć ostrzeżenia w prompcie systemowym, metadane o wiarygodności źródła lub dotrenowanie modelu na rozpoznawanie konfliktu. Żadna z tych metod nie działa uniwersalnie, ale ich kombinacja, dostrojona do konkretnego agenta, potrafi obniżyć adopcję błędów o 30-40 punktów procentowych.
Korzyści i ROI: więcej niż unikanie strat
Oczywistą korzyścią jest redukcja ryzyka operacyjnego. Mniej oczywistą – zgodność z regulacjami. Nadzór finansowy (KNF, EBA) coraz uważniej przygląda się modelom AI w bankowości. Wdrożenie systematycznego testu odporności na manipulację danymi to silny argument w procesie audytu. Dodatkowo, klienci zyskują zaufanie, gdy agent otwarcie komunikuje: 'otrzymałem sprzeczne informacje, proszę o weryfikację'. Widziałem prototyp takiego rozwiązania w jednym z polskich banków – po dodaniu warstwy ostrzegawczej, wskaźnik akceptacji rekomendacji spadł o 15%, ale zadowolenie klientów wzrosło, bo czuli, że mają kontrolę.
Podsumowanie: nie wierz agentowi na słowo
Jeśli wdrażasz agenta AI do analizy rynkowej lub oceny ryzyka, zleć zespołowi ds. ryzyka przeprowadzenie testu adopcji błędnych treści. To kilka dni pracy, a może uchronić przed decyzją wartą miliony. Technologia jest dostępna, metodologia opisana, a koszt zaniechania – liczony w stratach i utracie reputacji – jest znacznie wyższy niż koszt testu.
- Eliminacja ryzyka decyzji kredytowych i inwestycyjnych na podstawie zmanipulowanych danych zewnętrznych
- Standardowy test walidacyjny przedwdrożeniowy, oparty na metodologii naukowej
- Większe zaufanie klientów dzięki transparentności i ostrzeżeniom o konflikcie danych
Informacje o artykule
Ten artykuł powstał w oparciu o paper naukowy opublikowany w serwisie arXiv.
Paper: Agents Trust Tools Too Much: Measuring Reliance on Unreliable Tools
Autorzy: Hoyeol Yang, Woojung Song, Taewon Kim, Jonghyun Song, Seoyeon Park i in.
Existing evaluations of tool-using agents primarily measure whether an agent can successfully complete diverse tasks with tools. These evaluations generally assume that tools return reliable information. However, tool returns in real-world systems can be plausible yet incorrect. We investigate ho...
arXiv: arxiv.org/abs/2609.05587
Czytaj więcej o tej technologii: Gdy agent AI wie, że się myli, ale i tak podaje błąd
Artykuł wygenerowany ze wsparciem sztucznej inteligencji.

