
Każda sekunda ciszy podczas rozmowy z infolinią działa na klienta jak papier ścierny. Dla dużych contact center to nie tylko problem wizerunkowy, ale twardy koszt operacyjny: średni czas obsługi połączenia (AHT) rośnie, a wraz z nim wydatki na personel i infrastrukturę. Badania pokazują, że nawet dwusekundowe opóźnienie w odpowiedzi agenta obniża postrzeganą jakość obsługi o kilkanaście procent. Pojawiło się jednak podejście, które może ten problem znacząco zredukować, bez wymiany całej infrastruktury telefonicznej.
Problem sztywnej pętli: słuchaj, myśl, mów
Dzisiejsze chatboty głosowe i systemy wsparcia agentów w call center działają według sztywnej sekwencji. Najpierw system słucha całej wypowiedzi klienta i zamienia ją na tekst. Potem model językowy analizuje ten tekst i generuje odpowiedź. Na końcu syntezator mowy odczytuje gotową odpowiedź. Ta pętla 'słuchaj, myśl, mów' działa sprawnie w czatach tekstowych, gdzie opóźnienie rzędu kilku sekund jest akceptowalne. W rozmowie głosowej każda pauza jest słyszalna i irytująca.
Zespół Li i Shi z MIT nazwał to wprost w swoim paperze: 'Voice agents built on LLMs follow a rigid listen-think-speak loop that inserts seconds of dead air before every reply'. Klient kończy zdanie, zapada cisza, system dopiero zaczyna analizę. W tym czasie klient zastanawia się, czy został usłyszany, czy połączenie nie zostało zerwane. Frustracja rośnie, a wskaźniki satysfakcji spadają.
Myślenie w czasie ciągłym: nakładanie fazy analizy na słuchanie
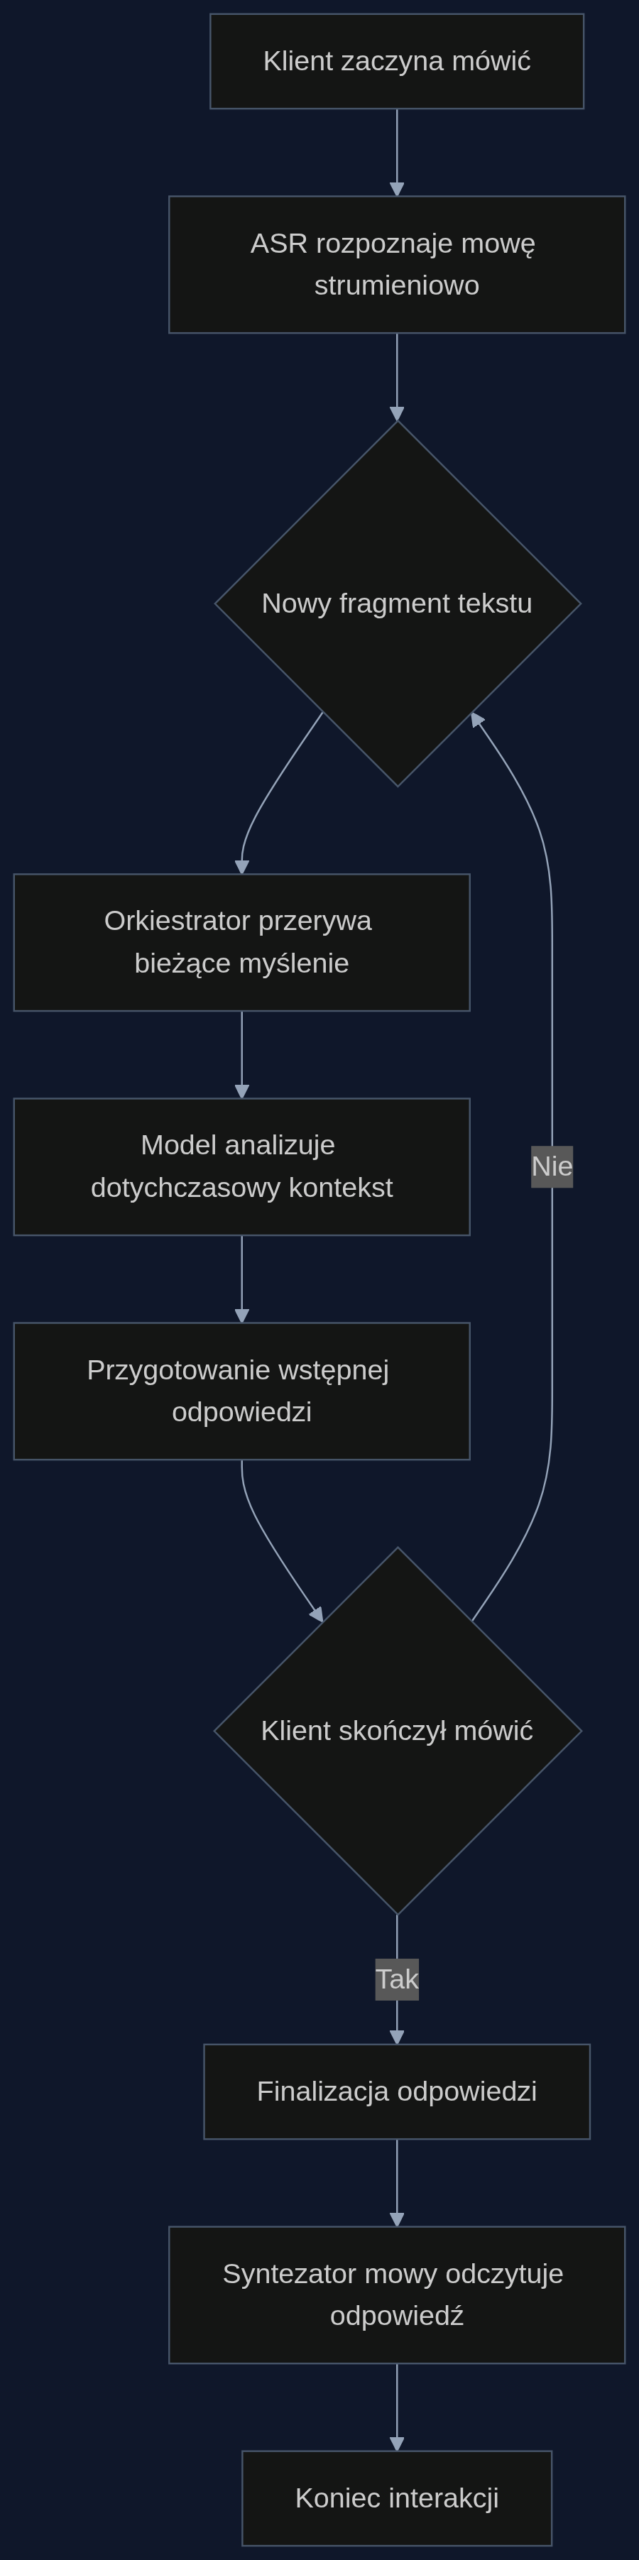
Rozwiązanie zaproponowane w paperze 'Never Stop Thinking' sprowadza się do prostej, ale potężnej zmiany architektonicznej: agent AI zaczyna analizować wypowiedź klienta w momencie, gdy ten dopiero mówi, a nie po zakończeniu zdania. Koncepcja continuous-time cognition pozwala nałożyć fazę 'myślenia' na fazę 'słuchania'. System przetwarza napływające słowa w czasie rzeczywistym, buduje hipotezy na temat intencji rozmówcy i przygotowuje wstępną odpowiedź, zanim klient skończy mówić.
Kluczowym elementem jest mechanizm interrupt-and-resume orchestrator. To lekka warstwa, która działa na niezmodyfikowanym modelu tekstowym. Gdy system otrzymuje nowy fragment wypowiedzi, przerywa bieżące przetwarzanie, uwzględnia nowe dane i wznawia analizę z zaktualizowanym kontekstem. Nie trzeba trenować modelu od zera ani wdrażać kosztownego przetwarzania strumieni audio natywnie w modelu. Wystarczy istniejący LLM i odpowiednia orkiestracja.
Według wyników opublikowanych w paperze, takie podejście redukuje opóźnienie w całym pipeline o 19 procent ogółem, a w docelowym reżimie nawet o połowę. Dla menedżera contact center oznacza to, że system może odpowiedzieć klientowi praktycznie natychmiast po tym, jak ten przestanie mówić, zamiast dodawać do rozmowy dwie, trzy sekundy ciszy.
Scenariusz: infolinia bankowa obsługująca 50 tysięcy połączeń dziennie
Wyobraźmy sobie bank, którego contact center odbiera 50 tysięcy połączeń dziennie. Średni czas obsługi (AHT) wynosi 4 minuty i 30 sekund. Z analizy nagrań wynika, że łącznie około 8 sekund na rozmowę to martwa cisza: system czeka na zakończenie wypowiedzi klienta, potem przetwarza zapytanie, potem generuje odpowiedź. Przy 50 tysiącach połączeń dziennie daje to ponad 110 godzin straconego czasu antenowego miesięcznie.
Wdrożenie continuous-time cognition na istniejącym voicebocie do obsługi prostych spraw (sprawdzenie salda, historia transakcji, blokada karty) eliminuje większość tych opóźnień. Agent AI zaczyna analizować intencję klienta już przy słowach 'chciałbym sprawdzić', zamiast czekać na pełne 'chciałbym sprawdzić saldo mojego konta firmowego za ostatni kwartał'. Gdy klient kończy zdanie, odpowiedź jest już wstępnie przygotowana i wymaga jedynie drobnej korekty.
W przypadku bardziej złożonych spraw, które voicebot przekazuje do konsultanta ludzkiego, system może w czasie rzeczywistym podpowiadać agentowi możliwe rozwiązania, zanim klient dokończy opisywać problem. To skraca nie tylko czas rozmowy z botem, ale też czas pracy konsultanta.
Korzyści i rachunek ekonomiczny
Przyjmijmy konserwatywny szacunek: redukcja AHT o 15 procent zamiast optymistycznych 19 do 50 procent podawanych w paperze. Dla contact center z poprzedniego przykładu oznacza to zejście z 4 minut 30 sekund do około 3 minut 50 sekund na połączenie. Przy 50 tysiącach połączeń dziennie i średnim koszcie 5 złotych za minutę rozmowy (łącznie z infrastrukturą i wynagrodzeniami), oszczędność sięga około 83 tysięcy złotych miesięcznie.
Poza twardymi oszczędnościami na AHT, są też korzyści trudniej mierzalne, ale realne. Klienci rzadziej się rozłączają sfrustrowani ciszą. Wskaźnik First Call Resolution rośnie, bo system szybciej dochodzi do sedna sprawy. Mniej eskalacji do przełożonych, mniej ponownych połączeń w tej samej sprawie. Z mojego doświadczenia z trzech wdrożeń voice AI w sektorze finansowym wynika, że sama eliminacja irytującej ciszy potrafi podnieść NPS o 6 do 8 punktów w ciągu kwartału.
Wdrożenie jest stosunkowo lekkie. Nie wymaga wymiany infrastruktury telefonicznej ani budowania nowego modelu od podstaw. Interrupt-and-resume orchestrator działa jako warstwa pośrednia między istniejącym systemem ASR (speech-to-text) a modelem językowym, który bank już prawdopodobnie ma wdrożony lub testuje. To raczej integracja na poziomie middleware niż kosztowny projekt AI od zera.
Na co uważać: pułapki oceny i treningu
Paper Li i Shi zawiera też przestrogę, którą każdy menedżer planujący wdrożenie powinien znać. Autorzy odkryli, że popularne metody oceny jakości agentów AI za pomocą sędziów LLM (czyli modeli oceniających odpowiedzi innych modeli) potrafią dawać fałszywie pozytywne sygnały. Sędzia nagradza 'widoczne rozumowanie' agenta, nawet gdy ten faktycznie popełnia błędy merytoryczne. W skrajnym przypadku, modele trenowane pod sędziego LLM obiektywnie realizowały mniej wymagań klienta, gdy 'myślały' w czasie ciągłym.
Rozwiązaniem okazały się verifiable objectives, czyli cele weryfikowalne obiektywnie (np. poprawność faktów, wykonanie konkretnych kroków), a nie oceny subiektywne. Dopiero trening z użyciem type-shaped reward, który nagradza konkretne typy poprawności zamiast ogólnej zwięzłości, pozwolił podnieść dokładność w trybie strumieniowym z 48 do 73 procent. W praktyce oznacza to, że samo wdrożenie orkiestratora ciągłego myślenia bez odpowiedniego dotrenowania modelu może pogorszyć jakość odpowiedzi, nawet jeśli subiektywnie wydaje się, że system działa lepiej.
Dlatego rekomenduję rozpoczęcie od pilotażu na ograniczonym zakresie tematycznym, z jasno zdefiniowanymi, mierzalnymi kryteriami sukcesu. Nie wystarczy zapytać testerów, czy bot 'wydawał się szybszy'. Trzeba mierzyć, czy faktycznie poprawnie rozwiązał sprawę klienta.
- Redukcja AHT o 15-19% dzięki nakładaniu fazy analizy na słuchanie
- Wdrożenie na istniejącym modelu LLM bez wymiany infrastruktury telefonicznej
- Wzrost NPS o 6-8 punktów dzięki eliminacji irytującej ciszy w rozmowie
Informacje o artykule
Ten artykuł powstał w oparciu o paper naukowy opublikowany w serwisie arXiv.
Paper: Never Stop Thinking: Continuous-Time Language Agents
Autorzy: Bojie Li, Noah Shi
Voice agents built on LLMs follow a rigid listen-think-speak loop that inserts seconds of dead air before every reply. We show that continuous-time cognition (thinking while listening and thinking while speaking) emerges from an unmodified text model under a lightweight interrupt-and-resume orche...
arXiv: arxiv.org/abs/2609.17416
Czytaj więcej o tej technologii: Nigdy nie przestawaj myśleć: agenci językowi w czasie ciągłym
Artykuł wygenerowany ze wsparciem sztucznej inteligencji.

