Różnica między literą a duchem prawa to stary problem, który nagle zyskał nowe znaczenie w kontekście sztucznej inteligencji. Kiedy przepis mówi jedno, a jego cel wskazuje co innego, sędziowie ważą racje od stuleci. Badacze sprawdzili, czy modele językowe można przygotować tak, żeby konsekwentnie wybierały jedną z tych interpretacji, szczególnie w sytuacjach granicznych.
Dylemat znany z codzienności
Wyobraźmy sobie tabliczkę przy wejściu do parku: 'Zakaz wjazdu pojazdów'. Czy rowerzysta łamie przepis? Literalnie tak, bo rower to pojazd. W duchu przepisu pewnie nie, bo autorowi chodziło o to, żeby w parku nie jeździły samochody. Takich pytań w prawie są setki, a odpowiedź często zależy od tego, którą szkołę interpretacji przyjmiemy.
Dla ludzi rozstrzyganie między literą a duchem bywa trudne, ale jest naturalne. Dla modeli językowych to wyzwanie, bo trzeba zrozumieć intencję, która nie jest wprost zapisana w tekście. Autorzy postawili pytanie: czy da się tak zmodyfikować model, żeby faworyzował jedno z tych podejść? Odpowiedź, którą uzyskali, zaskoczyła ich samych.
Jak piszą w podsumowaniu: 'Rozróżnienie między duchem a literą prawa to centralna kwestia zarówno w badaniach, jak i w codziennym życiu, a także rosnący problem przy budowaniu bezpiecznych, inteligentnych maszyn.'
Minimalne poprawki, wyraźny efekt
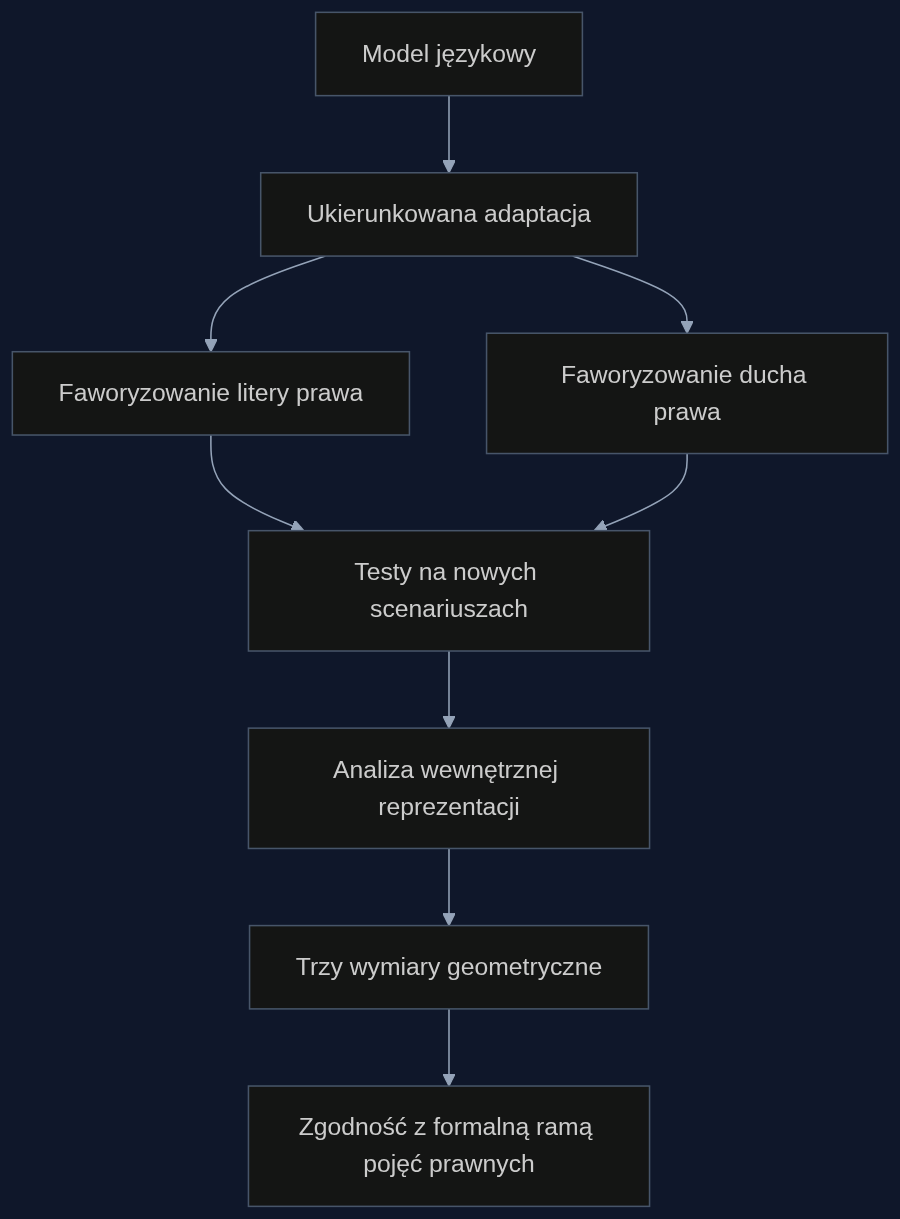
Zespół zastosował metodę, którą nazywa ukierunkowaną adaptacją. To sposób modyfikacji modelu, który wymaga niewielu zmian w wagach sieci neuronowej, a nie pełnego treningu od zera. Ta minimalna ingerencja wystarczyła, żeby zmienić sposób, w jaki model rozumie teksty prawne.
Najważniejszy wynik: modele po ukierunkowanej adaptacji zaczynały konsekwentnie faworyzować ducha albo literę prawa. Efekt był widoczny w różnych testach. Badacze sprawdzali zachowanie na nowych opisach sytuacji, na przykładach z życia codziennego i na znanych sprawach sądowych. Model przygotowany pod kątem litery prawa trzymał się zapisu nawet tam, gdzie interpretacja duchowa wydawałaby się rozsądna. I odwrotnie.
Efekt nie ograniczał się do przypadków, na których model trenowano. Uogólniał się na scenariusze, których model wcześniej nie widział. To sugeruje, że zmiana dotyczy głębszego mechanizmu rozumienia, a nie tylko zapamiętanych odpowiedzi.
Rozróżnienie między duchem a literą prawa to centralna kwestia zarówno w badaniach, jak i w codziennym życiu, a także rosnący problem przy budowaniu bezpiecznych, inteligentnych maszyn.
Qian, Li, Chen, Murthy, Belinkov, Ullman
Abstrakt
Geometria myślenia prawniczego
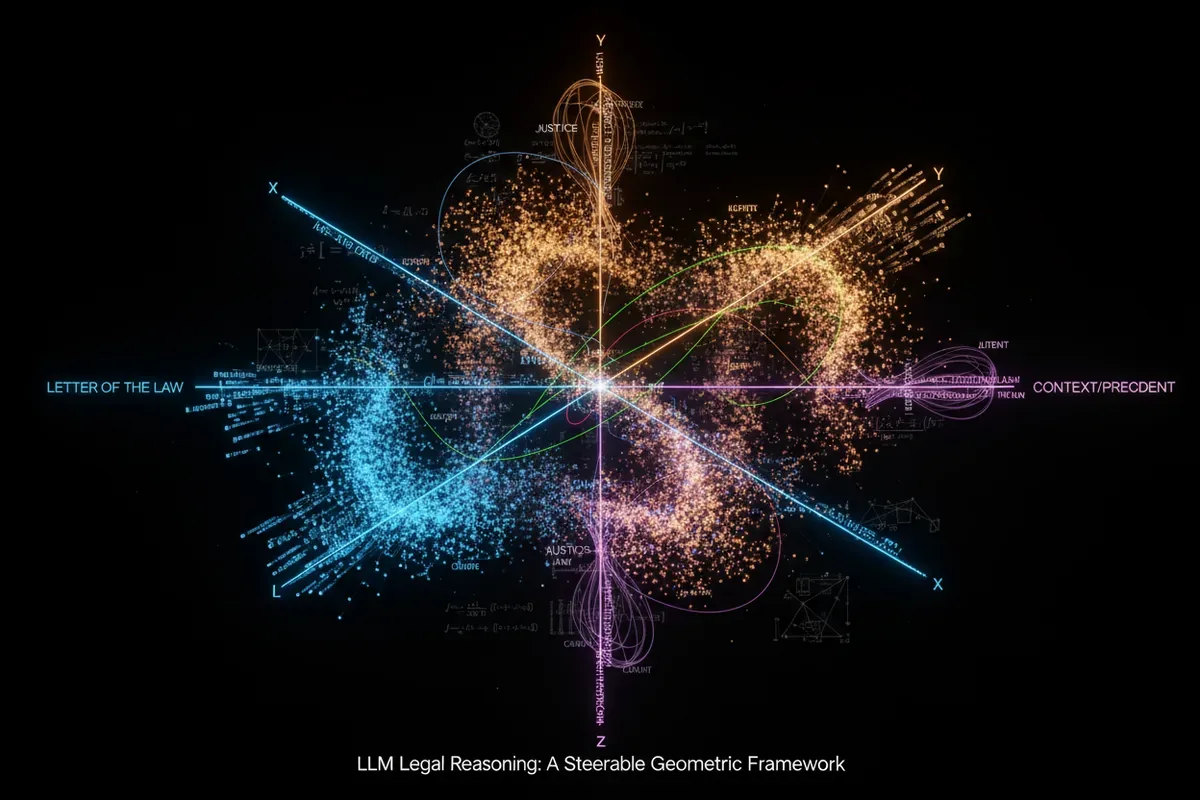
Szczerze, najbardziej zastanawia mnie to, co badacze znaleźli w środku modelu. Po przeanalizowaniu wewnętrznych reprezentacji okazało się, że informacje o literze i duchu prawa są zorganizowane w sposób, który ma strukturę geometryczną. Trzy wymiary wystarczyły, żeby opisać większość różnic w rozumieniu pojęć prawnych.
Te trzy wymiary nie są przypadkowe. Dopasowują się do formalnej ramy geometrycznej, którą badacze przygotowali wcześniej. Opisuje ona relacje między koncepcjami prawnymi jako strukturę geometryczną. Model sam wytworzył wewnętrzną mapę myślenia prawniczego, która odpowiada tej ramie.
Ten wynik ma w sobie coś eleganckiego. Pod powierzchnią skalujących się aktywacji neuronów kryje się uporządkowana przestrzeń, w której pojęcia takie jak intencja, zapis i wykładnia mają swoje miejsca. Pokazuje to, że myślenie o prawie w modelach ma przewidywalną strukturę, do której można się odnieść i którą można świadomie sterować.
Co to oznacza w praktyce
Systemy AI coraz częściej pomagają w analizie dokumentów prawnych, umów i regulacji. Model, który potrafi świadomie wybrać między literą a duchem, może lepiej doradzać w konkretnych sytuacjach. Firma sprawdzająca zgodność z regulacjami mogłaby używać modelu nastawionego na literę przepisu, kiedy potrzebuje ścisłej kontroli. Kancelaria prawna mogłaby preferować wariant ducha prawa, kiedy klient pyta o interpretację w niejasnej sprawie.
Nadal otwartych jest kilka pytań. Autorzy piszą, że technika wymaga więcej testów w warunkach produkcyjnych i że skutki uboczne takiej adaptacji trzeba zbadać. Nie wiadomo na przykład, czy model wytrenowany pod kątem litery prawa traci coś z ogólnej zdolności rozumienia kontekstu.
Mimo tych zastrzeżeń, praca daje do myślenia. Po raz pierwszy udało się pokazać, że wewnętrzna organizacja pojęć prawnych w modelu ma regularną, przewidywalną strukturę. A skoro tę strukturę widać i można nią sterować, to naturalny jest pomysł budowania narzędzi, które powiedzą: trzymam się zapisu, bo tak mówi prawo, albo: patrzę na cel tego przepisu, bo to ma sens w tej sytuacji.
- Ukierunkowana adaptacja wystarczy, żeby zmienić podejście modelu do interpretacji prawa
- Efekt uogólnia się na nowe scenariusze, przykłady z życia i znane sprawy sądowe
- Wewnątrz modelu badacze odkryli przestrzeń o trzech wymiarach, która opisuje relacje między pojęciami prawnymi
- Ta struktura jest zgodna z formalną ramą geometryczną przygotowaną wcześniej przez badaczy
- Metoda otwiera możliwości budowy narzędzi prawniczych o sterowalnym podejściu do interpretacji
Praktyczne zastosowania
Aby lepiej zrozumieć opisywaną innowację, przygotowaliśmy cztery przykłady praktycznego zastosowania tej technologii w różnych branżach:
Podsumowanie
Ta technologia ma naturalne zastosowanie w narzędziach prawniczych. Kancelarie mogłyby używać modeli nastawionych na ducha prawa do interpretacji umów, a działy compliance modeli nastawionych na literę przepisu do kontroli zgodności. W administracji publicznej możliwe jest zautomatyzowanie interpretacji regulacji z wyborem podejścia w zależności od kontekstu. W zarządzaniu korporacyjnym system mógłby podpowiadać, kiedy trzymać się procedur, a kiedy odwołać się do intencji polityki firmy.
Metryka artykułu źródłowego
Tytuł oryginalny: Directing large language models to follow the letter or spirit of the law
Autorzy: Peng Qian, Andrew Li, Sam Chen, Sonia K. Murthy, Yonatan Belinkov, Tomer D. Ullman
Data publikacji: 22 września 2026
arXiv: arxiv.org/abs/2609.23083
Napisanie tego artykułu zostało wspomagane przez sztuczną inteligencję. Treść opiera się na oryginalnym artykule naukowym, a jej dokładność została zweryfikowana automatycznie.

