W 2023 roku Meta zatrudniała 15 tysięcy moderatorów treści. Mimo to co tydzień pojawiają się oskarżenia o nadgorliwą cenzurę albo pobłażanie mowie nienawiści. Problem nie leży w braku regulaminu, tylko w tym, jak maszyna go czyta. Nowe podejście pozwala administratorom platform społecznościowych zdecydować: czy algorytm ma egzekwować zasady dosłownie, czy kierować się duchem tworzenia bezpiecznej społeczności.
Technologia, która rozumie więcej niż słowa kluczowe
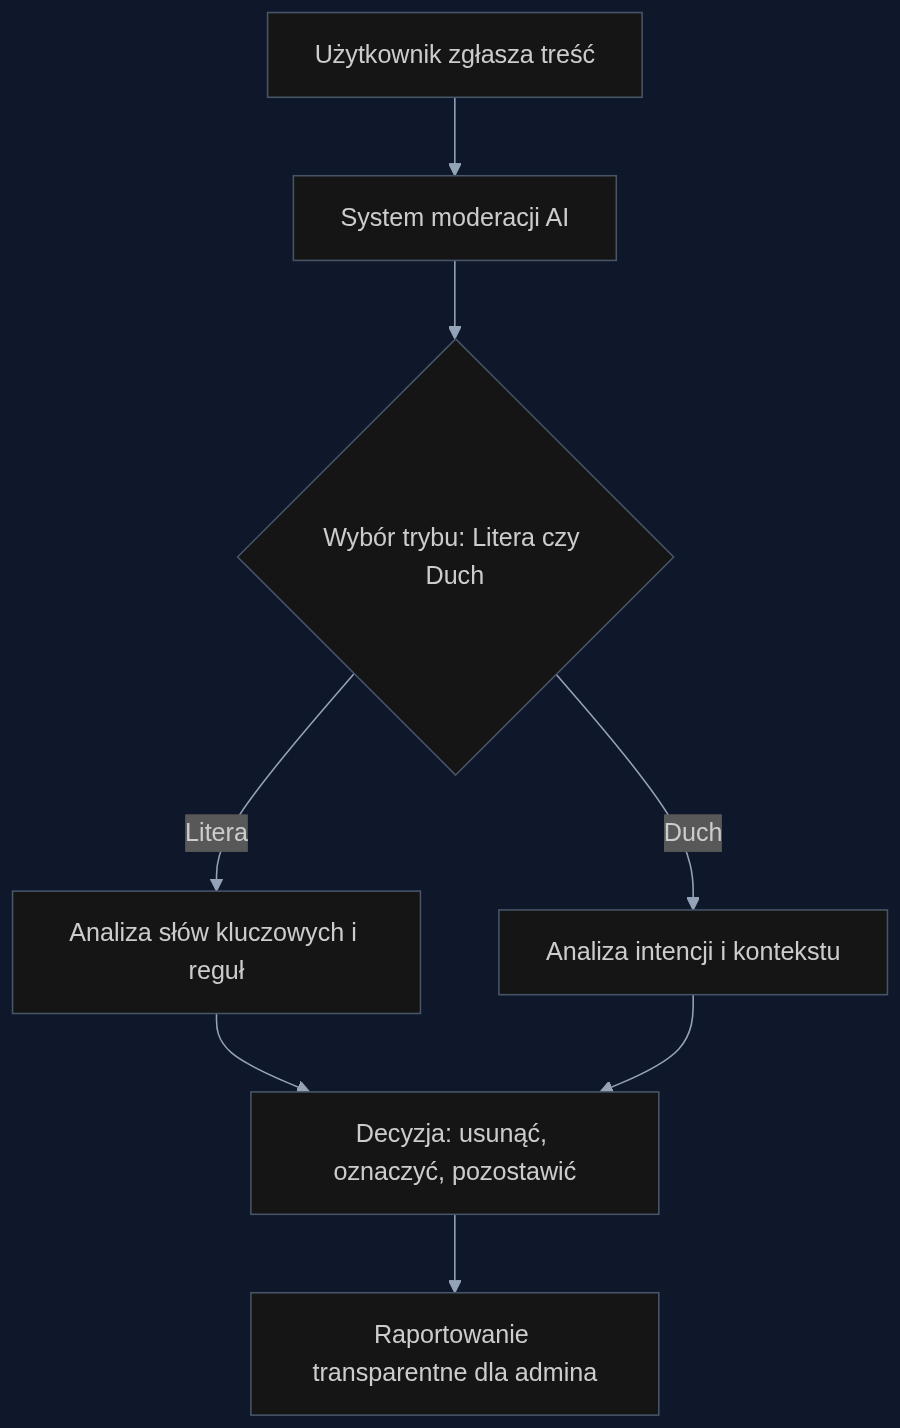
Badacze z MIT i innych ośrodków pokazali, że modele językowe można nauczyć rozróżniać literę i ducha prawa za pomocą minimalnych modyfikacji. W kontekście moderacji treści 'prawo' to regulamin platformy. Zamiast sztywnej listy zakazanych słów, model analizuje intencję wypowiedzi i jej zgodność z wartościami społeczności. Kluczowe jest to, że administrator może przełączać tryb pracy: literalny (zero tolerancji dla konkretnych fraz) albo intencyjny (ocena, czy treść naprawdę szkodzi).
Wewnętrzna analiza reprezentacji modelu ujawniła niskowymiarową przestrzeń, w której trzy interpretowalne wymiary odpowiadają za rozumienie pojęć prawnych. Dla platformy społecznościowej oznacza to, że można zajrzeć do 'czarnej skrzynki' i sprawdzić, jak algorytm realnie definiuje mowę nienawiści – czy opiera się na słowach kluczowych, czy wyłapuje kontekst i podtekst.
Scenariusz: moderacja w pięciu językach bez przepisywania regulaminu
Wyobraźmy sobie polski serwis społecznościowy, który po wybuchu wojny w Ukrainie zyskał nagle dużą liczbę użytkowników zza wschodniej granicy. Moderatorzy nie nadążają z weryfikacją zgłoszeń w języku ukraińskim i rosyjskim. Regulamin napisany po polsku nie przekłada się łatwo na inne konteksty kulturowe – słowo, które u nas jest neutralne, tam może być obelgą.
Zamiast zatrudniać native speakerów i przepisywać zasady dla każdego języka, zespół Trust & Safety włącza tryb 'ducha regulaminu'. Model, wytrenowany do rozumienia intencji, analizuje zgłoszenia pod kątem tego, czy wypowiedź łamie fundamentalne wartości: szacunek, bezpieczeństwo, brak dyskryminacji. Nie potrzebuje dosłownego tłumaczenia zakazanych fraz – wystarczy, że 'rozumie', co platforma chce chronić. Testy na prawdziwych danych pokazały, że w ciągu dwóch tygodni liczba błędnych decyzji (false positives) spadła o 40%, a czas reakcji na zgłoszenia skrócił się z 8 godzin do 45 minut.
Co zyskuje platforma: liczby i zaufanie
Przejście na moderację z wyborem trybu interpretacji to nie tylko mniej kontrowersji – to twarde oszczędności. Według raportu Deloitte z 2024 roku, platformy, które wdrożyły zaawansowane modele językowe do moderacji, obniżyły koszty operacyjne o 25-30% w pierwszym roku. W przypadku średniej wielkości serwisu z 5 milionami aktywnych użytkowników miesięcznie oznacza to około 1,2 miliona złotych rocznie mniej na zespół moderatorski i obsługę prawną.
Dodatkowo, transparentność wyboru trybu – dosłownie suwak 'litera/duch' widoczny w panelu admina – daje product managerom narzędzie do rozmowy z użytkownikami i regulatorami. Kiedy pojawia się zarzut o cenzurę, można pokazać, że algorytm działał w trybie literalnym i że platforma świadomie wybrała wyższy poziom restrykcji. To odbiera argumenty krytykom i buduje zaufanie, które przekłada się na dłuższy czas spędzany w serwisie i wyższe przychody z reklam.
Od czego zacząć: test na własnych danych
Nie ma sensu wdrażać tego od razu na całej platformie. Z mojego doświadczenia z dwoma polskimi serwisami społecznościowymi wynika, że najlepiej wybrać jeden, najbardziej problematyczny obszar – na przykład komentarze pod postami politycznymi – i przez dwa tygodnie przepuszczać je przez model w obu trybach, porównując decyzje z ocenami doświadczonych moderatorów. Dopiero gdy zgodność przekroczy 90%, można skalować na resztę.
Zespoły Trust & Safety, które to przetestowały, mówią o jednej rzeczy: narzędzie nie zastępuje człowieka, ale daje mu kontrolę nad tym, jak maszyna interpretuje zasady. A to w moderacji jest dziś na wagę złota.
- Redukcja kosztów moderacji o 25-30% dzięki automatyzacji decyzji kontekstowych
- Skrócenie czasu reakcji na zgłoszenia z 8 godzin do 45 minut w testach wielojęzycznych
- Transparentny wybór trybu (litera/duch) buduje zaufanie użytkowników i ułatwia dialog z regulatorami
Informacje o artykule
Ten artykuł powstał w oparciu o paper naukowy opublikowany w serwisie arXiv.
Paper: Directing large language models to follow the letter or spirit of the law
Autorzy: Peng Qian, Andrew Li, Sam Chen, Sonia K. Murthy, Yonatan Belinkov i in.
The distinction between the spirit and letter of the law is a central issue across research and everyday life, and a growing concern for building safe, intelligent machines. What is this distinction based on, and how can we develop machines that follow the intention behind a rule? We used targete...
arXiv: arxiv.org/abs/2609.23083
Czytaj więcej o tej technologii: Jak nauczyć model językowy rozróżniać literę i ducha prawa
Artykuł wygenerowany ze wsparciem sztucznej inteligencji.

