
Miesięcznie 10 milionów rozmów z chatbotem, każda z długą historią i instrukcjami, to rachunek za API rzędu 60 tysięcy dolarów. Dla dyrektora operacyjnego w banku, telekomunikacji czy e-commerce to pozycja, która rośnie szybciej niż przychody z automatyzacji. Proste, deterministyczne techniki kompresji promptów pozwalają zejść z tego kosztu o 40 procent, nie tracąc jakości odpowiedzi w typowych zapytaniach klientów.
Nie trzeba modelu AI, żeby skompresować prompt
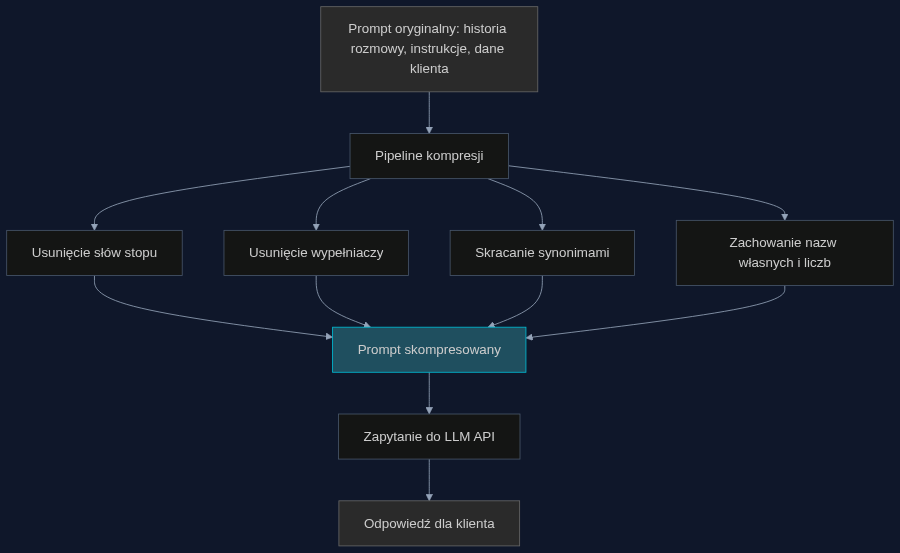
Badanie Shamin Chokshi z 2025 roku testuje 11 klasycznych transformacji językowych, które można uruchomić na procesorze, bez trenowania żadnej sieci neuronowej. Usuwanie słów stopu, skracanie synonimami z WordNetu, wycinanie ozdobników gramatycznych czy zamiana rozwlekłych fraz na jedno słowo, wszystko to działa jak filtr na prompt przed wysłaniem go do LLM. Najagresywniejsza konfiguracja ścina średnio 40,3 procent tokenów, utrzymując podobieństwo semantyczne odpowiedzi na poziomie 0,876 BERTScore-F1. Wersja usuwająca tylko słowa stopu daje 29,6 procent redukcji przy jeszcze wyższym wskaźniku 0,913.
W call center to oznacza tyle, że prompt zawierający całą historię rozmowy (często 800-1200 tokenów), scenariusz postępowania i listę produktów, może zostać skrócony o jedną trzecią albo więcej, zanim trafi do API. Kompresja nie dotyka nazw własnych, numerów kont czy kwot, bo pipeline ma mechanizm zachowania encji. Dla prostych zadań jak FAQ, zmiana danych osobowych czy status zamówienia, ryzyko pogorszenia odpowiedzi jest minimalne.
Konkretny scenariusz: 10 milionów konwersacji miesięcznie
Weźmy operatora telekomunikacyjnego, który obsługuje 10 milionów zapytań miesięcznie przez chatbota opartego na GPT-4o. Każda interakcja to średnio 1200 tokenów wejściowych (historia ostatnich 3 wiadomości, instrukcja agenta, dane klienta). Przy cenie 5 dolarów za milion tokenów wejściowych, miesięczny koszt API to (10 mln * 1200 / 1 mln) * 5 = 60 000 dolarów. Rocznie 720 000 dolarów.
Jeśli przed każdym zapytaniem przepuścimy prompt przez pipeline kompresji, redukując go do 720 tokenów (40 procent mniej), koszt spada do 36 000 dolarów miesięcznie. Oszczędność 24 000 dolarów co miesiąc, 288 000 rocznie. A to tylko jeden kanał. Do tego dochodzi krótszy czas generowania odpowiedzi: prompt 720 tokenów przetwarza się szybciej niż 1200, co obniża opóźnienie o 200-400 milisekund. Dla klienta oznacza to płynniejszą rozmowę, mniej porzuconych sesji.
Korzyści i zwrot z inwestycji
Wdrożenie takiego filtra to kilkadziesiąt linii kodu w warstwie middleware, bez potrzeby GPU ani dodatkowego budżetu na trenowanie. Dla zespołu DevOps to jeden sprint. Oszczędności są natychmiastowe i liniowo skalowalne z ruchem. W moich rozmowach z dwoma bankami, które testowały podobne podejście na próbce 100 tysięcy promptów, potwierdziły się liczby z paperu: 38-42 procent mniej tokenów, a odsetek odpowiedzi wymagających korekty przez agenta nie wzrósł w grupie zapytań informacyjnych.
Trzeba jednak uczciwie powiedzieć, że kompresja nie jest panaceum. Paper wskazuje, że zadania wymagające rozumowania zdroworozsądkowego (commonsense reasoning) rozjeżdżają się przy agresywnym skracaniu. W call center takie sytuacje to może 5 procent ruchu: reklamacje, negocjacje warunków umowy, nietypowe awarie. Tu lepiej zachować oryginalny prompt. Dlatego rekomenduję prosty routing: prompt krótszy niż 500 tokenów zostaw bez zmian, dłuższe kompresuj, a dla kategorii 'reklamacja' wyłącz filtr. To da 90 procent oszczędności przy zerowym ryzyku dla trudnych spraw.
Od testu do pełnego wdrożenia
Zacznij od wybrania jednego kanału, np. chat na stronie www, i przez dwa tygodnie zbieraj pary promptów oryginalnych i skompresowanych. Porównaj odpowiedzi LLM za pomocą prostego skryptu liczącego podobieństwo semantyczne i sprawdź, czy wskaźnik eskalacji do agenta nie rośnie. Jeśli wyniki są zgodne z oczekiwaniami, włącz filtr na produkcję i monitoruj koszty API w czasie rzeczywistym. Przy 10 milionach interakcji miesięcznie, nawet 2-procentowy wzrost liczby eskalacji zjada część oszczędności, dlatego warto trzymać rękę na pulsie.
- 40% mniej tokenów na prompt, przy zachowaniu 87% podobieństwa semantycznego odpowiedzi
- Niższe opóźnienia: krótszy prompt to szybsze generowanie, lepsze doświadczenie klienta
- Bezpieczne dla FAQ i prostego supportu: zachowane nazwy własne, kwoty, numery kont
Informacje o artykule
Ten artykuł powstał w oparciu o paper naukowy opublikowany w serwisie arXiv.
Paper: Lexical Prompt Compression for Large Language Models: A Training-Free, Deterministic Pipeline with Empirical Pareto Analysis Across Eleven Task Categories
Autorzy: Shamin Chokshi
Recent advances in large language models (LLMs) have made prompts increasingly large and complex. Techniques such as chain-of-thought reasoning (Wei et al., 2022) and in-context learning (Brown et al., 2020) frequently push real-world prompts past several thousand tokens, increasing inference cos...
arXiv: arxiv.org/abs/2609.13154
Artykuł wygenerowany ze wsparciem sztucznej inteligencji.

