
Długie prompty kosztują. Każdy token to milisekundy i grosze, a w skali setek tysięcy zapytań robi się z tego konkretny budżet. Shamin Chokshi pokazał, że można przyciąć prompt o 40%, nie dotykając modelu, nie trenując niczego i nie tracąc zbyt wiele z sensu odpowiedzi. Używa do tego narzędzi, które pamiętają jeszcze czasy przed transformerami.
Stare sztuczki w nowej roli
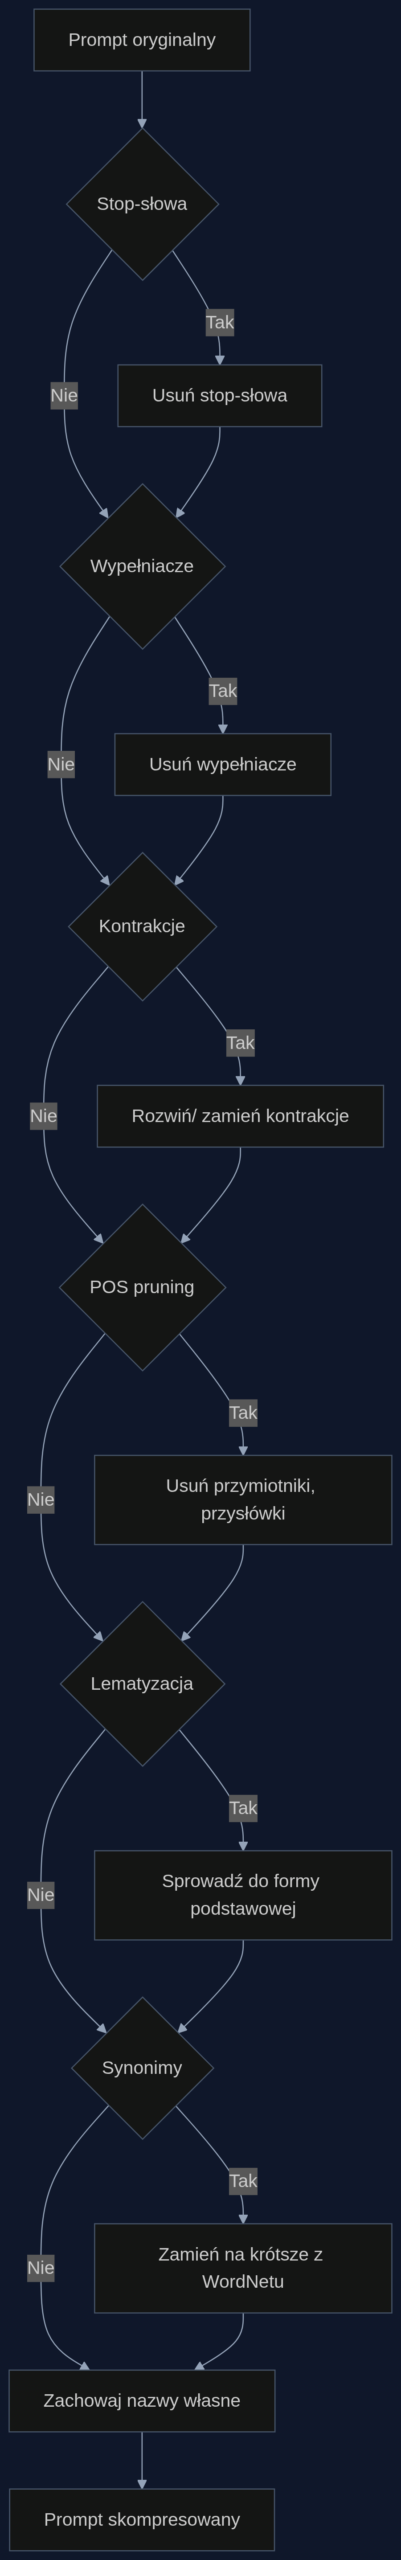
Pipeline Chokshiego to zestaw jedenastu przełączników, które można włączać i wyłączać niezależnie. Żadnych sieci neuronowych, żadnego fine-tuningu, tylko deterministyczne reguły działające na CPU. Brzmi banalnie? Bo jest banalne. Właśnie dlatego działa od ręki i nie kosztuje nic poza czasem procesora.
Lista transformacji: usuwanie stop-słów (tych 'się', 'że', 'aby'), wycinanie wypełniaczy ('w zasadzie', 'tak naprawdę'), zamiana skrótów i kontrakcji ('niech' zamiast 'niech będzie'), przycinanie na podstawie części mowy (przymiotniki, przysłówki lecą pierwsze), lematyzacja (sprowadzanie słów do formy podstawowej), zamiana na krótsze synonimy z WordNetu i, co ważne, zachowanie nazw własnych. Nazwy firm, daty, kwoty – te zostają nienaruszone, bo ich utrata mogłaby rozwalić sens zapytania.
Wszystko to jest w pełni deterministyczne. Ten sam prompt skompresujesz sto razy i dostaniesz identyczny wynik. Żadnego losowego szumu, żadnych halucynacji na etapie skracania. Dla kogoś, kto wysyła miliony promptów do API, to ma znaczenie – wiesz dokładnie, co leci do modelu.
Test na 1242 promptach: co się stało z odpowiedziami
Autor zebrał 1242 angielskie prompty z sześciu źródeł: Dolly-15k, LMSYS-Chat-1M, WildChat-1M, MMLU, GSM8K i HellaSwag. Automatycznie podzielił je na 11 kategorii – od prostego streszczania po rozumowanie zdroworozsądkowe. Potem przepuścił przez 15 konfiguracji pipeline'u, generując łącznie 18 630 par odpowiedzi (oryginalny prompt i skompresowany prompt do GPT-4o-mini).
Najbardziej agresywna konfiguracja – wszystkie przełączniki włączone – ścięła prompt średnio o 40,3% tokenów (odchylenie standardowe 9,2), osiągając BERTScore-F1 na poziomie 0,876. To znaczy, że odpowiedzi były bardzo podobne do tych z oryginalnych promptów, ale nie identyczne. Dla porównania, samo usuwanie stop-słów dało 29,6% redukcji przy BERTScore-F1 0,913 – trochę mniej oszczędności, ale wyższa wierność.
Chokshi nie poprzestał na jednej metryce. Mierzył też BLEU, ROUGE-1/2/L i podobieństwo kosinusowe SentenceBERT. Dla każdej kategorii zadań wyznaczył granicę Pareto – krzywą pokazującą, gdzie kończy się kompromis między stopniem kompresji a jakością odpowiedzi. Nie ma jednej idealnej konfiguracji; wszystko zależy od tego, co jest dla ciebie ważniejsze: oszczędność tokenów czy precyzja.
Najbardziej agresywna konfiguracja osiąga średnią redukcję tokenów o 40,3% (sigma = 9,2) przy BERTScore-F1 0,876 w porównaniu z wynikiem oryginalnego promptu; konfiguracja usuwająca tylko stop-słowa daje 29,6% redukcji przy 0,913.
Shamin Chokshi
arXiv:2609.13154
Gdzie to działa, a gdzie się psuje
Największą porażką agresywnej kompresji okazało się rozumowanie zdroworozsądkowe (commonsense reasoning). Prompt skrócony o 40% często gubił niuanse niezbędne do podjęcia sensownej decyzji. W takich zadaniach BERTScore spadał znacznie poniżej średniej, a odpowiedzi stawały się niespójne.
Z drugiej strony, zadania czysto informacyjne – klasyfikacja, ekstrakcja danych, proste podsumowania – znosiły kompresję zaskakująco dobrze. Tam, gdzie prompt jest tylko nośnikiem faktów, a nie logiczną układanką, wycięcie ozdobników nie robi wielkiej różnicy. To dobra wiadomość dla firm, które używają LLM-ów do przetwarzania setek podobnych zapytań dziennie.
Pipeline nie dotyka chain-of-thought ani przykładów in-context learning. Te techniki z natury produkują długie prompty i autor świadomie je pomija, bo ich kompresja to osobny problem. Na razie skupia się na tym, co da się zrobić tanio i przewidywalnie.
Praktyczne zastosowania: kiedy warto kompresować
Jeśli płacisz za API na token, a wysyłasz dziesiątki tysięcy promptów miesięcznie, 40% mniej tokenów to 40% niższy rachunek. Nawet ostrożniejsza wersja ze stop-słowami daje prawie 30% oszczędności przy minimalnym ryzyku pogorszenia odpowiedzi. Dla startupu budującego chatbota obsługi klienta to może być różnica między opłacalnością a dziurą w budżecie.
Pipeline jest też całkowicie niezależny od modelu. Nie musisz go trenować, nie musisz mieć GPU, nie musisz integrować kolejnego API. Bierzesz prompt, przepuszczasz przez skrypt w Pythonie i wysyłasz skróconą wersję do GPT-4, Claude'a czy czegokolwiek innego. Żadnych vendor lock-inów, żadnych dodatkowych kosztów.
Szczerze, nie wiem, czy to zastąpi bardziej zaawansowane metody kompresji, ale ma jedną zaletę, której nie ma żaden model uczenia maszynowego: jest przewidywalne. Wiesz dokładnie, które słowa znikną i dlaczego. W zastosowaniach, gdzie prompt zawiera wrażliwe dane, ta przejrzystość jest bezcenna.
- Najlepsza konfiguracja: 40,3% mniej tokenów, BERTScore-F1 0,876 (dość podobne odpowiedzi).
- Bezpieczniejsza opcja: samo usuwanie stop-słów daje 29,6% oszczędności przy wyższej wierności (0,913).
- Rozumowanie zdroworozsądkowe nie znosi agresywnego skracania – gubi kluczowe niuanse.
- Pipeline jest darmowy, działa na CPU, nie wymaga trenowania i jest w pełni deterministyczny.
Praktyczne zastosowania
Aby lepiej zrozumieć opisywaną innowację, przygotowaliśmy cztery przykłady praktycznego zastosowania tej technologii w różnych branżach:
Podsumowanie
Pipeline Chokshiego to tania, przewidywalna metoda na obcięcie rachunków za API przy masowym przetwarzaniu prostych promptów – chatboty, klasyfikacja, ekstrakcja danych. Dla zadań wymagających rozumowania lepiej zostać przy bezpieczniejszej konfiguracji albo nie kompresować wcale. Dwa konkretne obszary, gdzie to zadziała od ręki: systemy obsługi klienta z powtarzalnymi zapytaniami i pipeline'y analizy dokumentów, gdzie prompt jest szablonem, a nie logiczną łamigłówką.
Metryka artykułu źródłowego
Tytuł oryginalny: Lexical Prompt Compression for Large Language Models: A Training-Free, Deterministic Pipeline with Empirical Pareto Analysis Across Eleven Task Categories
Autorzy: Shamin Chokshi
Data publikacji: 15 września 2026
arXiv: arxiv.org/abs/2609.13154
Napisanie tego artykułu zostało wspomagane przez sztuczną inteligencję. Treść opiera się na oryginalnym artykule naukowym, a jej dokładność została zweryfikowana automatycznie.
