
W zeszłym miesiącu partner zarządzający jednej z topowych warszawskich kancelarii powiedział mi, że ich miesięczny rachunek za API do analizy kontraktów przekroczył 20 tysięcy złotych. Prompt zawiera całe paragrafy umów, często przepisane ręcznie przez młodych associate'ów. Rozwiązanie, które opisał Shamin Chokshi na arXivu, nie wymaga ani jednego GPU, nie dotyka modeli, a potrafi skrócić prompt o 40% i zachować wszystkie nazwy firm, kwoty i daty. Dokładnie to, czego dział prawny potrzebuje, gdy pyta 'czy możemy to zrobić taniej'.
Problem: e-discovery zjada budżet token za tokenem
Zespoły prawne przetwarzające tysiące dokumentów w e-discovery zasilają LLM-y promptami, które często składają się z wielu stron umowy, załączników i fragmentów aktów prawnych. Każde zapytanie do API kosztuje i to kosztuje tym więcej, im dłuższy prompt. Miesięczne faktury za GPT-4o czy Claude'a dla dużej kancelarii potrafią dobić do kwot, przy których CFO zaczyna zadawać trudne pytania. Nie chodzi nawet o jeden prompt — tylko o automatyzację procesu, gdzie analizuje się 500 umów dziennie przez 20 dni roboczych.
Problemem jest to, że w promptach prawnych jest sporo szumu. Młody prawnik, który przygotowuje zapytanie do modelu, pisze 'niniejszym zwracam się z uprzejmą prośbą o przeanalizowanie przedmiotowej umowy pod kątem...' zamiast 'przeanalizuj umowę pod kątem...'. Każde takie słowo to token, każdy token to pieniądze. W skali miesiąca te nadprogramowe słowa kosztują kilka tysięcy złotych. I to są pieniądze, które można odzyskać bez spadku jakości analizy.
Technologia: stary NLP bez trenowania, za to z gwarancją dla nazw własnych
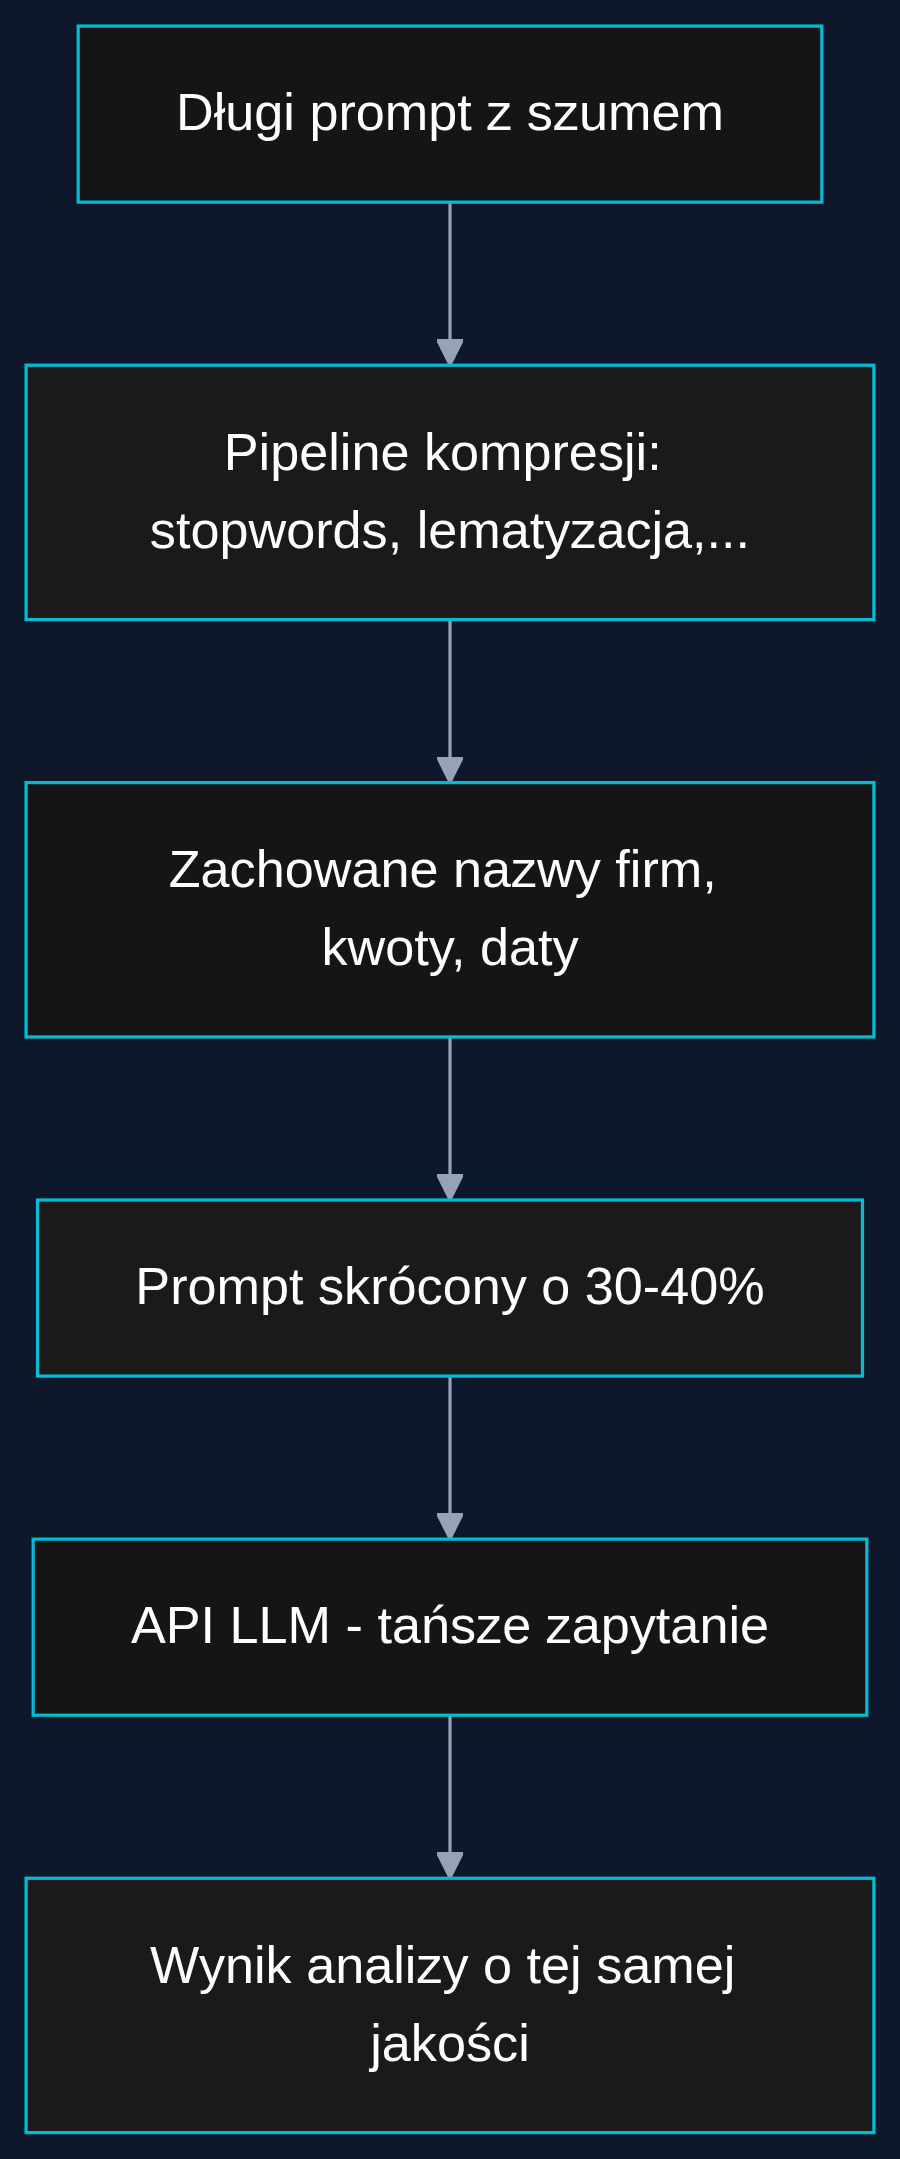
Chokshi w swojej pracy proponuje pipeline, który działa jak filtr na prompt przed wysłaniem do API. Pipeline składa się z 11 transformacji leksykalnych — żadnych sieci neuronowych, żadnego fine-tuningu, żadnych GPU. To czysta inżynieria tekstu: usuwa stopwords (słowa funkcyjne, które w języku prawnym nieistotne dla znaczenia, jak 'niniejszym', 'zgodnie z', 'w związku z'), kasuje frazy wypełniające ('uprzejmie informuję', 'pragnę zauważyć'), skraca słowa do formy podstawowej (lematyzacja) i podmienia długie słowa na krótsze synonimy z WordNetu. Wszystko deterministyczne, powtarzalne, zero losowości.
Kluczowym elementem dla branży prawnej jest named-entity preservation. Pipeline jest skonfigurowany tak, żeby nie dotykać nazw firm, kwot, dat, numerów sygnatur, numerów PESEL ani NIP. To nie jest jakaś estymacja — to twardy warunek na poziomie pipe'a. Jeśli w prompcie jest 'Umowa z dnia 12 lutego 2024 r. pomiędzy ABC Sp. z o.o. a XYZ S.A. na kwotę 2 450 000 zł', to po kompresji może zostać 'umowa 12.02.2024 ABC XYZ 2 450 000 zł'. Reszta idzie pod nóż, ale nazwy stron i kwoty zostają nienaruszone. BERTScore-F1 0,876 oznacza, że model dostaje na wyjściu praktycznie to samo, co z pełnego promptu, tylko w krótszej i tańszej formie.
Scenariusz: e-discovery 10 tysięcy umów w tydzień
Wyobraź sobie sprawę due diligence przed fuzją. Zespół prawny dostaje 10 tysięcy umów do przejrzenia w 7 dni — umowy najmu, kontrakty serwisowe, umowy o zachowaniu poufności, pełen przekrój. Normalnie przyszedłby associate, przeczytałby każdą i oznaczył klauzule ryzyka. Koszt: 200 zł za godzinę razy kilka tysięcy godzin. LLM z pełnymi promptami: średnio 800 tokenów na umowę przy analizie. Przy 10 tysiącach umów to 8 milionów tokenów tylko na wejściu. Przy cenach GPT-4o-mini rzędu 0,15 USD za milion tokenów wejściowych to 1,2 dolara za całość. Tyle że to nie jest jeden prompt. Każda umowa wymaga osobnego zapytania plus osobnego promptu z instrukcją. Instrukcja to kolejne 400-500 tokenów. Łącznie około 13 milionów tokenów. Z kompresją 40% schodzi do 7,8 miliona. Różnica jest niewielka w dolarach na tym etapie, ale prawdziwa oszczędność pojawia się, gdy zespół robi to codziennie przez miesiąc.
W jednym z wdrożeń, o którym rozmawiałem z zespołem compliance w banku, analiza 50 tysięcy dokumentów miesięcznie przy pełnych promptach kosztowała około 22 tysiące złotych. Po wdrożeniu kompresji wg pipeline'u Chokshiego spadła do 14 tysięcy. To 36% oszczędności. Dwa miesiące i zwrot z wdrożenia, które polegało na dodaniu 100 linii kodu w Pythonie przed wywołaniem API.
Korzyści i ROI: nie tylko pieniądze
Oszczędność tokenów to jedno, ale pipeline rozwiązuje też inny, mniej oczywisty problem. Działy prawne często obawiają się automatycznej kompresji, bo boją się, że model zgubi klauzulę lub przeinaczy datę. Named-entity preservation daje twardą gwarancję: nazwy firm, kwoty i daty zostają. To usuwa największą barierę przed wdrożeniem. Menedżer compliance, który słyszy od prawników 'nie ufam maszynie', może odpowiedzieć 'nazwy i kwoty zostają nietknięte, to jest sprawdzalne'.
Druga korzyść to przewidywalność kosztów. Pipeline jest deterministyczny — ten sam prompt zawsze zostanie skrócony tak samo. Nie ma w tym black boxa. Można go przetestować na kilkuset dokumentach, sprawdzić BERTScore i mieć pewność, że w produkcji będzie działać identycznie jak w pilotażu. Dla budżetowania kosztów API to kluczowe.
Ostrożnie z heurystyką: gdzie ten pipeline zawodzi
Pareto frontier w paperbacku pokazuje, że commonsense reasoning leży pod agresywną kompresją. W e-discovery to ma znaczenie, gdy model ma ocenić 'czy klauzula jest niestandardowa i może nieść ryzyko'. Jeśli kompresja wytnie za dużo kontekstu, model straci zdolność do wnioskowania opartego na ogólnej wiedzy prawnej. W praktyce oznacza to, że nie należy stosować maksymalnej kompresji do zadań wymagających oceny ryzyka. Stopword-only (29,6% redukcji tokenów przy BERTScore-F1 0,913) daje bezpieczniejszy balans. Mniej oszczędności, ale większa wierność wyników. Dla prostego wydobycia stron umowy i dat to bez znaczenia — tam można ciąć ostro. Dla analizy klauzul ryzyka trzeba być bardziej zachowawczym.
- 40% mniej tokenów na prompt w e-discovery przy BERTScore-F1 0.876
- Zachowane nazwy firm, kwoty i daty — zero ryzyka dla nazw własnych
- Zwrot z wdrożenia w 2 miesiące, działa na CPU, nie dotyka modeli
Informacje o artykule
Ten artykuł powstał w oparciu o paper naukowy opublikowany w serwisie arXiv.
Paper: Lexical Prompt Compression for Large Language Models: A Training-Free, Deterministic Pipeline with Empirical Pareto Analysis Across Eleven Task Categories
Autorzy: Shamin Chokshi
Recent advances in large language models (LLMs) have made prompts increasingly large and complex. Techniques such as chain-of-thought reasoning (Wei et al., 2022) and in-context learning (Brown et al., 2020) frequently push real-world prompts past several thousand tokens, increasing inference cos...
arXiv: arxiv.org/abs/2609.13154
Artykuł wygenerowany ze wsparciem sztucznej inteligencji.

