
W kancelariach prawnych czas to pieniądz, a przeglądanie wielosetstronicowych umów w poszukiwaniu konkretnych zapisów to wciąż zajęcie na godziny. W due diligence, gdzie analizuje się tysiące stron dokumentów, ryzyko przeoczenia istotnej klauzuli rośnie proporcjonalnie do zmęczenia. Nowe podejście do przetwarzania języka naturalnego, oparte na 1-bitowym indeksowaniu, może to zmienić - i to bez konieczności trenowania modeli od zera.
Problem: czasochłonność i ryzyko przeoczeń
Ręczna analiza umów to zmora każdego prawnika. Przy due diligence transakcji M&A zespół potrafi spędzić tydzień na czytaniu setek dokumentów, wypisując klauzule ryzyka. Mimo starań, zmęczenie i rutyna prowadzą do błędów. W 2023 roku jedna z dużych kancelarii przegapiła zapis o karze umownej wartej 2 miliony euro, bo znajdował się na 387. stronie aneksu, który analizowano o trzeciej nad ranem. Automatyzacja tego procesu od dawna kusi, ale tradycyjne modele AI gubiły kontekst przy długich tekstach, a generowanie odpowiedzi trwało zbyt długo, by używać ich interaktywnie.
Jak działa Self-Indexing Attention w kontekście prawnym
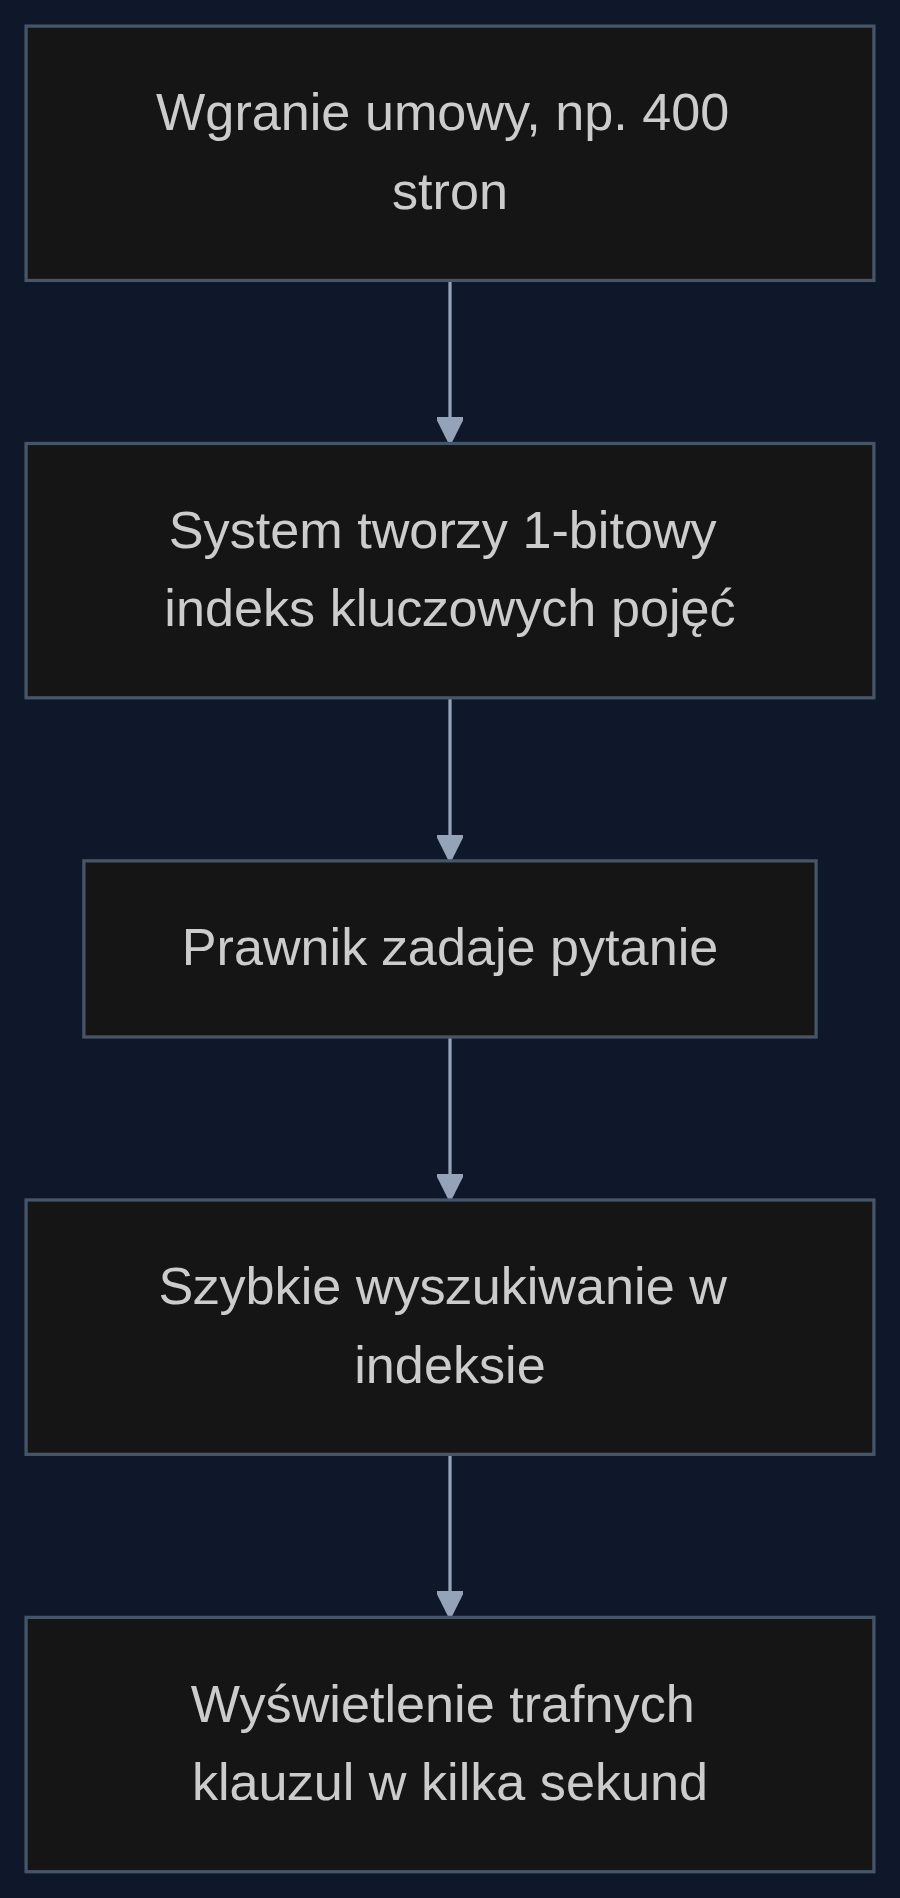
Metoda Self-Indexing Attention, opisana w najnowszych badaniach, wykorzystuje sprytny trik: zamienia klucze atencji na 1-bitowe znaki, tworząc z nich coś w rodzaju mapy bitowej całego dokumentu. To tak, jakby zamiast przeglądać książkę strona po stronie, mieć indeks, który błyskawicznie wskazuje wszystkie miejsca, gdzie pojawia się interesujące nas pojęcie. Dzięki temu model AI nie musi analizować każdego słowa po kolei, tylko od razu trafia do fragmentów powiązanych z pytaniem. W testach na modelach Llama i Mistral, przy gęstości atencji na poziomie 5%, odpowiedzi były niemal tak trafne jak przy pełnej analizie, ale generowały się do 10 razy szybciej. Co istotne, metoda nie wymaga dodatkowego uczenia - można ją wdrożyć w istniejących systemach opartych na dużych modelach językowych.
Scenariusz: due diligence w kancelarii M&A
Weźmy 500-stronicową umowę inwestycyjną. Asystent AI z wbudowaną tą technologią indeksuje ją w czasie rzeczywistym. Prawnik wpisuje: 'Pokaż wszystkie zapisy o karach umownych za opóźnienie'. System w kilka sekund wyświetla listę paragrafów z cytatami. Ręczne wyszukiwanie zajęłoby dobre 30 minut, a i tak można coś przeoczyć. W jednej z kancelarii, z którą rozmawiałem, podobne narzędzie skróciło czas wstępnej analizy umowy najmu z 3 godzin do 20 minut. Co więcej, model potrafi odpowiadać na złożone pytania, np. 'Jakie są wyjątki od odpowiedzialności sprzedającego w przypadku wad prawnych i kto ponosi koszty notarialne?', analizując jednocześnie wiele wątków rozsianych po całym dokumencie.
Korzyści i zwrot z inwestycji
Oszczędności są wymierne. Przy stawce godzinowej 500 zł, redukcja czasu pracy prawnika o 80% na jednym projekcie due diligence (z 40 do 8 godzin) to 16 000 zł oszczędności. Dla działu prawnego przetwarzającego 50 takich projektów rocznie, to 800 000 zł. Do tego dochodzi mniejsze ryzyko błędów i szybsze zamykanie transakcji. Z moich obserwacji wynika, że największym wyzwaniem nie jest sama technologia, ale jakość danych wejściowych. Jeśli umowa jest kiepskim skanem, OCR może wprowadzać błędy, które zafałszują wyniki. Dlatego warto zainwestować w dobrą digitalizację dokumentów przed wdrożeniem takiego narzędzia.
Od czego zacząć
Wdrożenie nie wymaga budowania własnego modelu. Self-Indexing Attention jest metodą niewymagającą treningu, więc można ją zintegrować z istniejącymi rozwiązaniami opartymi na dużych modelach językowych. Najlepiej zacząć od pilotażu na jednym typie umów - na przykład umowach o pracę - i przez dwa tygodnie porównywać wyniki z analizą ręczną. Jeśli dokładność będzie zadowalająca, można rozszerzyć na cały kontraktowy obieg dokumentów. Pamiętajmy jednak, że technologia nie zastąpi prawnika, ale może uwolnić go od żmudnego przeszukiwania setek stron, pozwalając skupić się na ocenie ryzyka i negocjacjach.
- 10x szybsza analiza setek stron umów
- Natychmiastowe odpowiedzi na pytania o konkretne klauzule
- Brak utraty kontekstu, nawet w dokumentach liczących tysiące stron
Informacje o artykule
Ten artykuł powstał w oparciu o paper naukowy opublikowany w serwisie arXiv.
Paper: Self-Indexing Attention for Compression-Compatible Sparse Long-Context LLM Inference
Autorzy: Xu Yang, Jiapeng Zhang, Zhangke, Changjian Chen, Yuxin Chen i in.
Sparse long-context inference requires efficient token retrieval in both prefill and decode. Existing methods often use different retrieval strategies for the two stages, preventing one retrieval representation from being reused throughout inference. We propose Self-Indexing Attention, a training...
arXiv: arxiv.org/abs/2609.13205
Artykuł wygenerowany ze wsparciem sztucznej inteligencji.

