
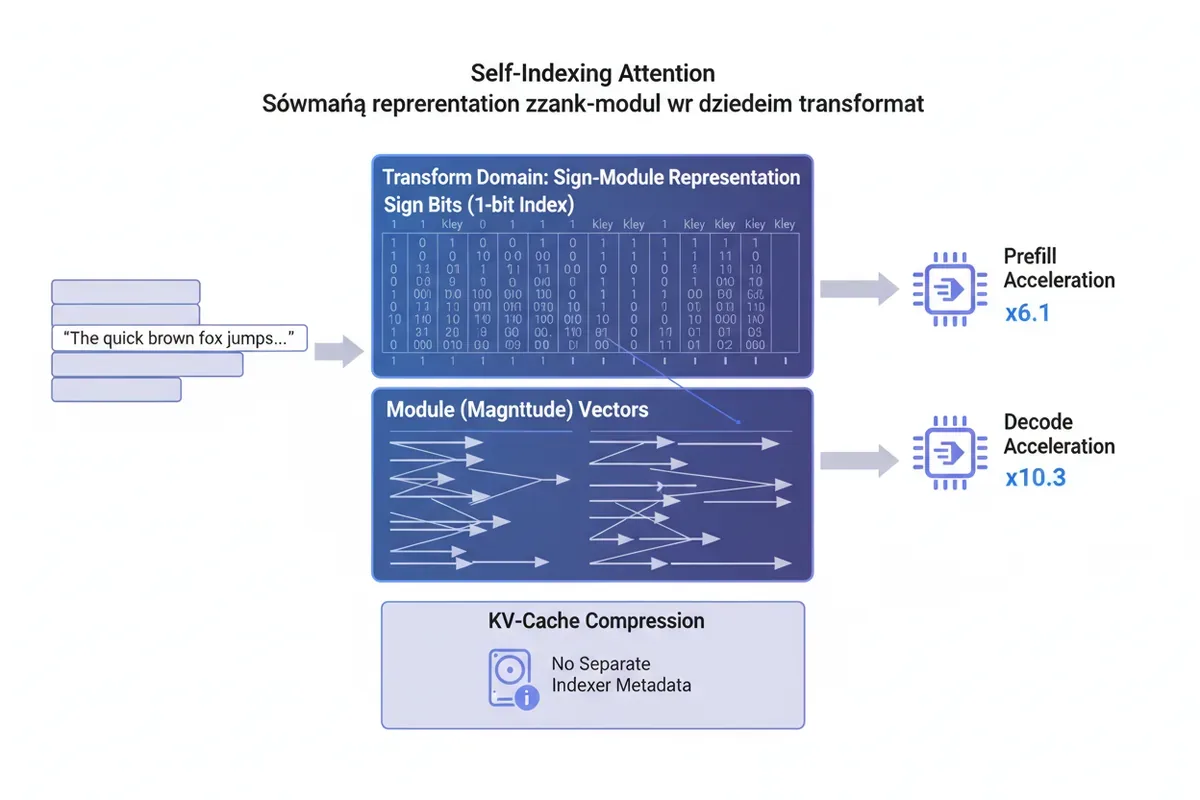
Długie konteksty w modelach językowych pożerają pamięć i czas – każdy dodatkowy token mnoży obliczenia. Zespół Xu Yanga znalazł sposób, żeby z samych kluczy atencji zrobić odchudzony indeks, który mówi modelowi, które tokeny są ważne, a które można zignorować. Bez trenowania, bez dodatkowej pamięci na metadane, za to z 10-krotnym przyspieszeniem fazy generowania.
Dlaczego długi kontekst boli i gdzie tkwi problem
Standardowa atencja w modelach typu Transformer skaluje się kwadratowo z długością wejścia. Dla 100 tysięcy tokenów oznacza to 10 miliardów operacji na jedną warstwę. Nawet z KV-cache, który przechowuje raz obliczone klucze i wartości, faza generowania (decode) wciąż musi przejrzeć całą historię, żeby wybrać odpowiedni kolejny token.
Ratunkiem jest rzadka atencja – świadome pomijanie mniej istotnych części kontekstu. Tylko że dotychczasowe metody albo wymagały osobnego treningu modelu (jak DeepSeekV4-Flash), albo trzymania w pamięci dodatkowych struktur indeksujących, które same zajmowały miejsce i komplikowały kompresję KV-cache. Self-Indexing Attention omija ten dylemat: indeks nie dokleja się do modelu, tylko wyciąga z tego, co już jest.
1-bitowy indeks z samego środka atencji
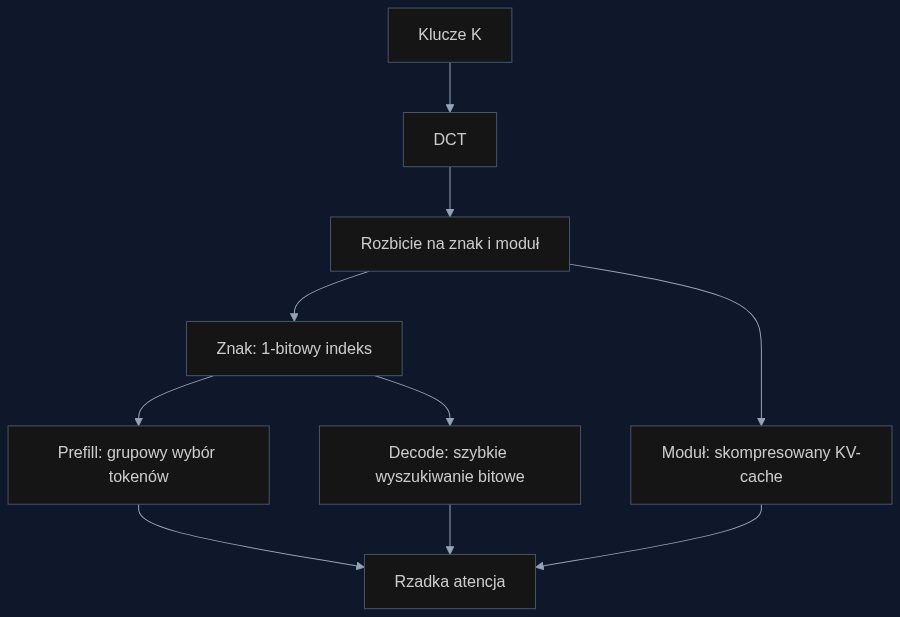
Autorzy biorą klucze (tensory K) i przepuszczają je przez dyskretną transformację kosinusową (DCT). To przenosi informację do dziedziny częstotliwości i pozwala rozbić każdy element na dwie części: znak (+1 lub -1) oraz moduł (wartość bezwzględna). Znaki wszystkich kluczy tworzą razem 1-bitową mapę, która działa jak indeks – mówi modelowi, w których miejscach kontekstu może znajdować się coś istotnego.
W fazie prefill (przetwarzanie zapytania) indeks ten grupuje tokeny o podobnych znakach, wybierając mały podzbiór do pełnego obliczenia atencji. W fazie decode, gdy model generuje kolejne słowa, ten sam indeks umożliwia szybkie wyszukanie tokenów najbardziej zbliżonych do bieżącego zapytania – wystarczy kilka operacji bitowych na iloczynie skalarnym. "Znaki kluczy dostarczają wielokrotnego użytku indeksu na poziomie tokenów do grupowego wyboru w prefillsie i wyszukiwania w decode, a ta sama reprezentacja pozostaje kompatybilna z zewnętrzną kompresją KV-cache bez oddzielnych metadanych indeksera" – tłumaczy Xu Yang.
Proponujemy Self-Indexing Attention, niewymagającą treningu ramę zbudowaną na wspólnej reprezentacji znak-moduł w dziedzinie transformaty.
Xu Yang i współpracownicy
Abstrakt
Przyspieszenie bez utraty jakości? Tak, do pewnej granicy
W testach na benchmarkach LongBench i RULER metoda utrzymuje wyniki bardzo blisko gęstej atencji, nawet gdy oblicza tylko 5% tokenów. To oznacza, że pomija 95% pracy, a odpowiedzi wciąż są sensowne. Co ciekawe, spadek dokładności nie jest równomierny – w zadaniach wymagających śledzenia wielu wątków naraz model z rzadką atencją radzi sobie gorzej, ale w prostszym streszczaniu czy odpowiadaniu na pytania różnica jest ledwo widoczna.
Liczby robią wrażenie: dla operatora atencji w fazie prefill przyspieszenie sięga 6,1 raza, a dla decode 10,3 raza w porównaniu z pełną atencją. "Przy 5% gęstości atencji Self-Indexing Attention pozostaje blisko gęstej atencji na LongBench i RULER oraz osiąga do 6,1x przyspieszenia w prefillsie i 10,3x w decode" – podsumowują autorzy. W praktyce oznacza to, że model Llama z taką optymalizacją mógłby obsłużyć znacznie dłuższe prompt'y na tym samym sprzęcie.
Kompresja KV-cache i ukłon w stronę istniejących rozwiązań
Oddzielne metadane indeksera były zmorą wcześniejszych podejść – zajmowały pamięć i utrudniały kompresję. Tutaj indeks i skompresowany moduł kluczy są dwiema stronami tej samej reprezentacji, więc nic nie trzeba dorzucać. Zespół pokazał, że metoda działa z TurboQuant, czyli niskobitową kompresją KV-cache, oraz z wytrenowanym indekserem DeepSeekV4-Flash, co otwiera drogę do łączenia jej z gotowymi, wstępnie nauczonymi selektorami tokenów.
Same operacje bitowe na 1-bitowym indeksie są szeroko wspierane sprzętowo przez nowoczesne GPU i akceleratory, więc implementacja nie wymaga egzotycznych bibliotek. Można to wpiąć jako plugin do istniejących silników wnioskowania, bez dotykania wag modelu.
- 1-bitowy indeks zbudowany ze znaków kluczy zastępuje osobne metadane – zero dodatkowej pamięci.
- Przy 5% gęstości atencji wyniki na LongBench i RULER są prawie takie jak przy pełnej atencji.
- Przyspieszenie fazy decode do 10,3x otwiera drzwi do interaktywnego przetwarzania długich dokumentów.
- Kompatybilność z kompresją KV-cache (TurboQuant) i wytrenowanymi indekserami (DeepSeekV4-Flash) ułatwia integrację z istniejącymi potokami.
Praktyczne zastosowania
Aby lepiej zrozumieć opisywaną innowację, przygotowaliśmy cztery przykłady praktycznego zastosowania tej technologii w różnych branżach:
Podsumowanie
Self-Indexing Attention nie wymaga zmiany architektury modelu ani dodatkowego treningu, więc można ją wdrożyć jako optymalizację na poziomie silnika wnioskowania. W analizie długich dokumentów prawniczych czy medycznych pozwala na kilkukrotnie szybsze generowanie odpowiedzi przy tym samym sprzęcie. W systemach RAG (Retrieval-Augmented Generation) umożliwia efektywne przeszukiwanie dużych zbiorów odzyskanych fragmentów bez rozrostu pamięci KV-cache.
Metryka artykułu źródłowego
Tytuł oryginalny: Self-Indexing Attention for Compression-Compatible Sparse Long-Context LLM Inference
Autorzy: Xu Yang, Jiapeng Zhang, Zhangke, Changjian Chen, Yuxin Chen, Feiqiang Sun, Chengguang Xu, Feng Jin, Zhuo Tang
Data publikacji: 15 września 2026
arXiv: arxiv.org/abs/2609.13205
Napisanie tego artykułu zostało wspomagane przez sztuczną inteligencję. Treść opiera się na oryginalnym artykule naukowym, a jej dokładność została zweryfikowana automatycznie.

